Retour sur la première conférence dédiée au développement augmenté !
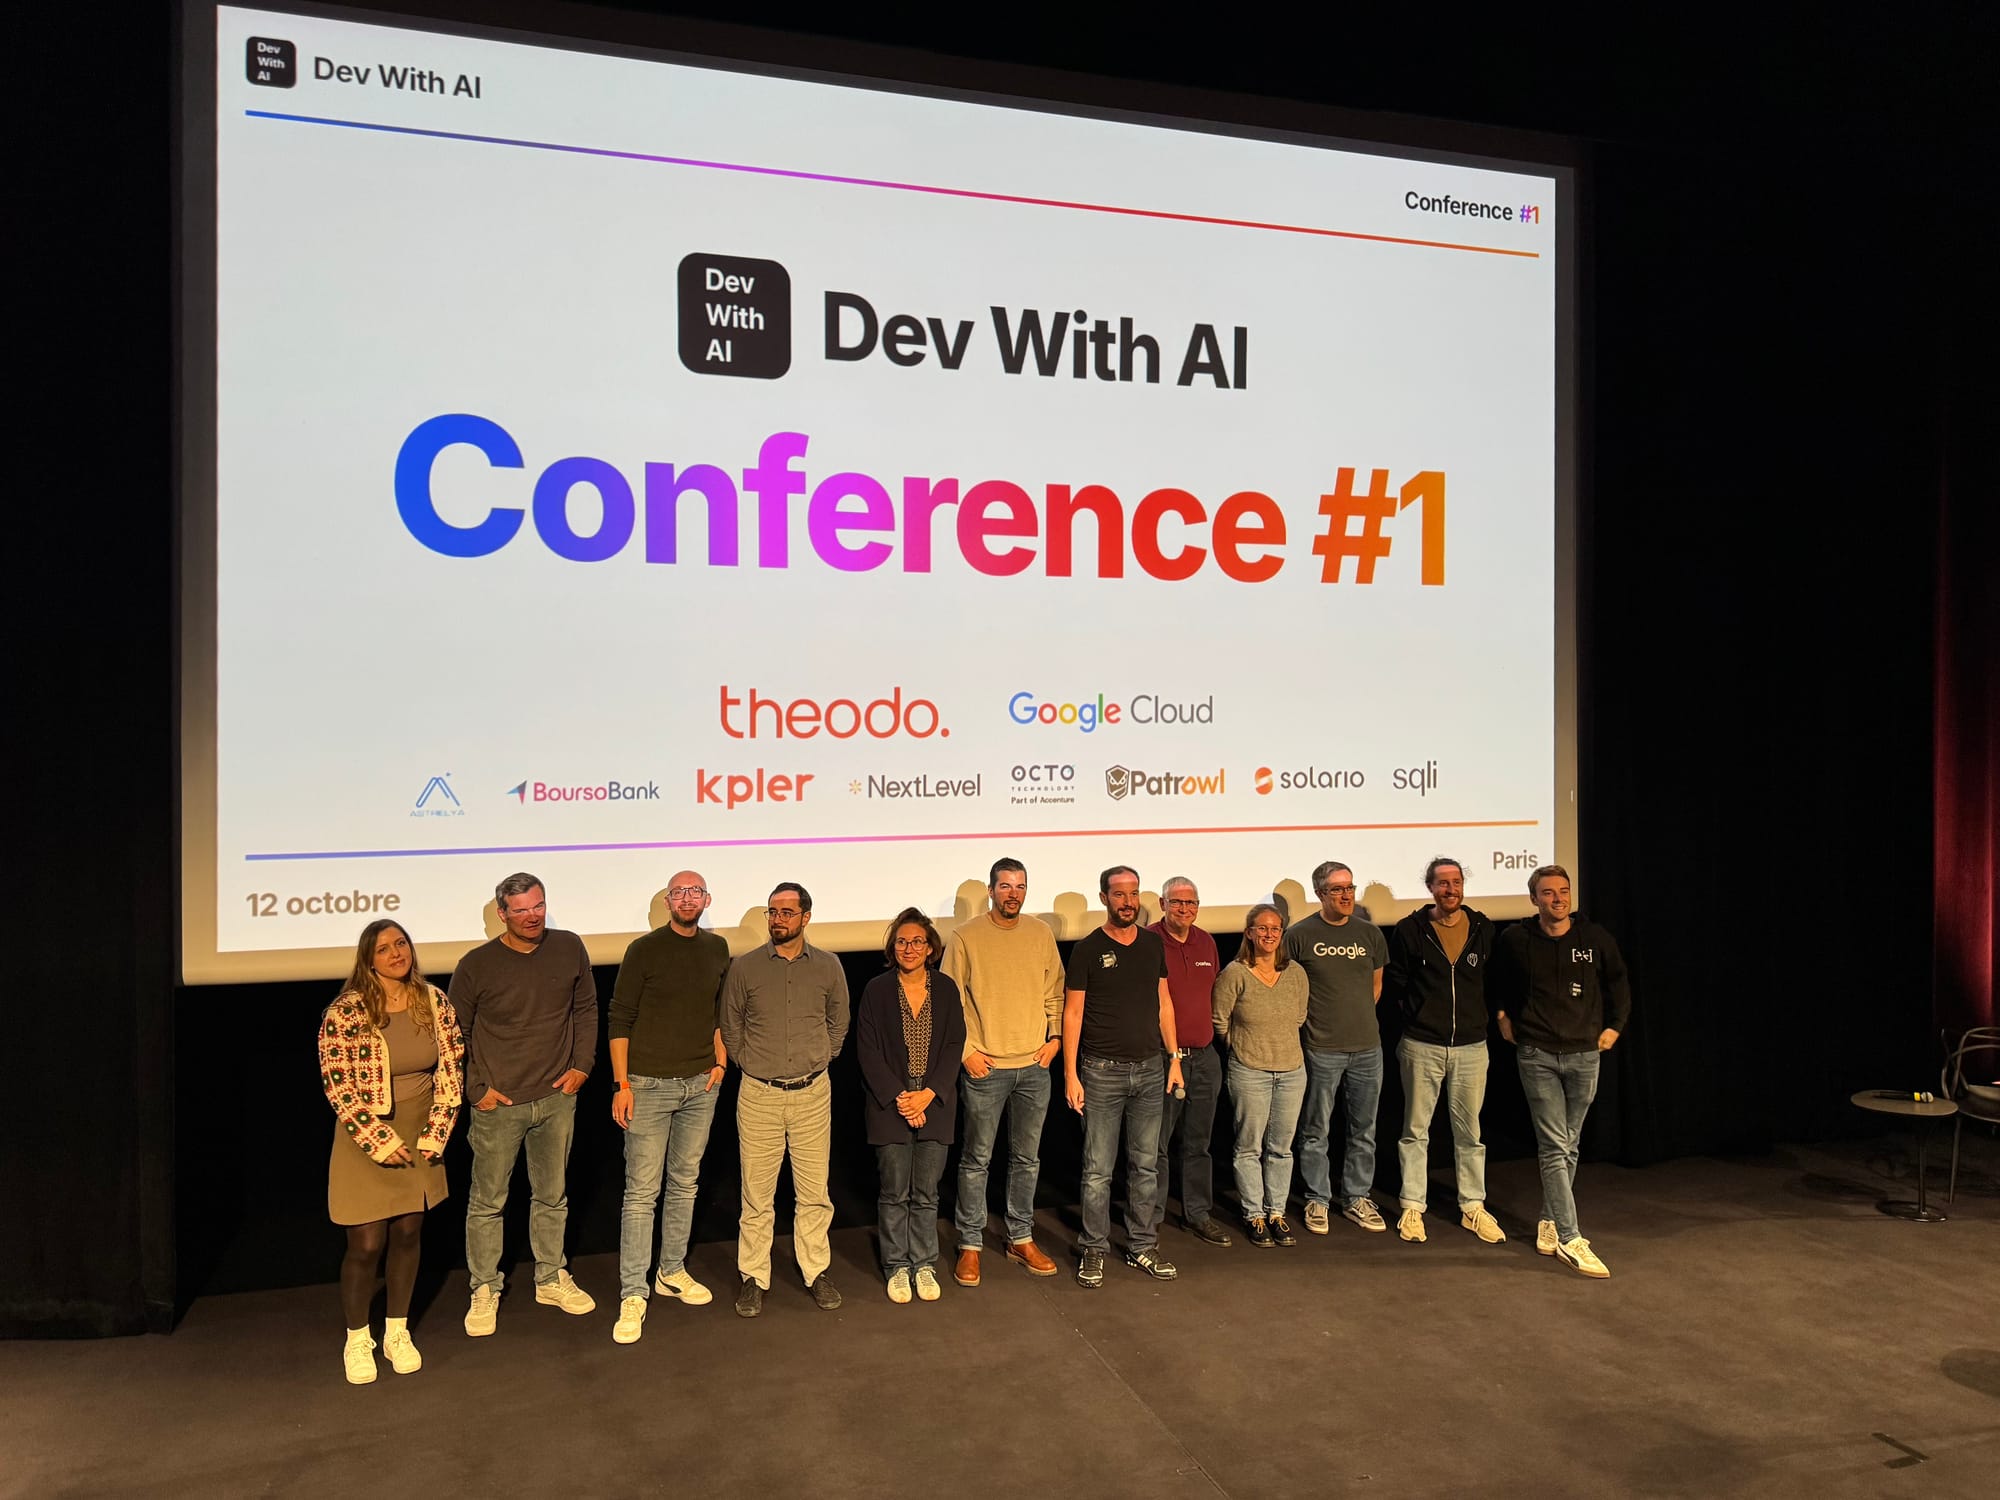
Le 12 octobre 2026, au Forum des Images à Paris, 16 intervenants ont raconté comment ils développent avec l'IA. Leur constat commun est que l'IA écrit du code plus vite qu'on ne sait le relire, le tester et l'intégrer.
Les cinq points ci-dessous répondent donc à deux questions: comment bien guider l'agent, et comment vérifier ce qu'il produit.
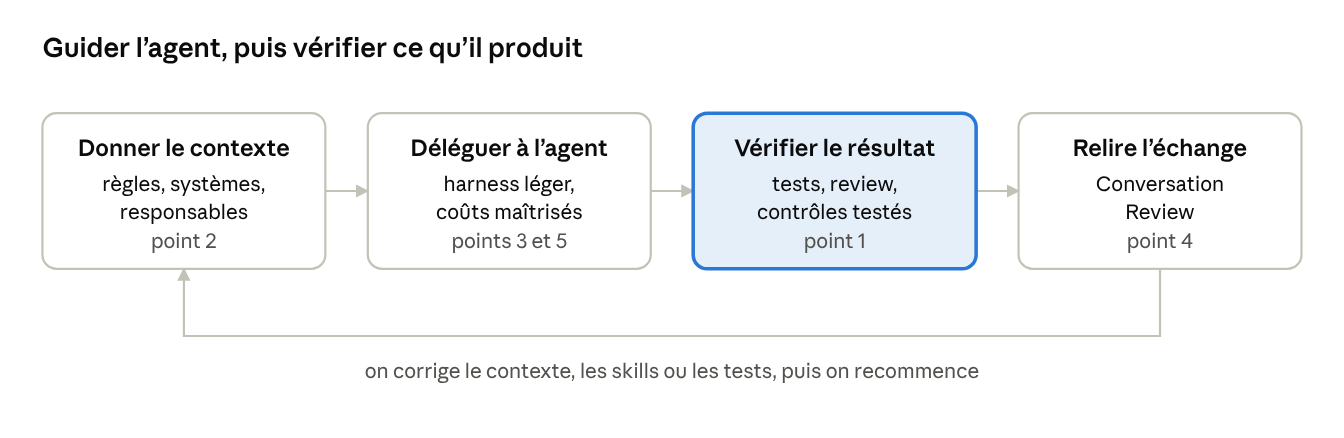
La vérification est l'étape qui coince aujourd'hui. La relecture de l'échange sert à améliorer le tour suivant.
1. Vérifier ce que l'agent produit
Un agent peut annoncer qu'un travail est terminé alors qu'il ne l'est pas.
Chez Dorra Bartaguiz (Arolla), il affirmait avoir atteint la couverture de tests demandée, mais la mesure réelle était différente, et le code comme les tests contenaient des défauts. Pour s'en rendre compte, elle utilise le mutation testing : on introduit volontairement une erreur dans le programme et on vérifie que les tests la repèrent (voir un de nos articles de 2020)
Florian Bruniaux ajoute qu'un outil de review peut trouver le bon problème et proposer la mauvaise correction. Jean-Louis Rigau va plus loin : l'outil qui juge le travail de l'agent peut lui-même se tromper, dans les deux sens.
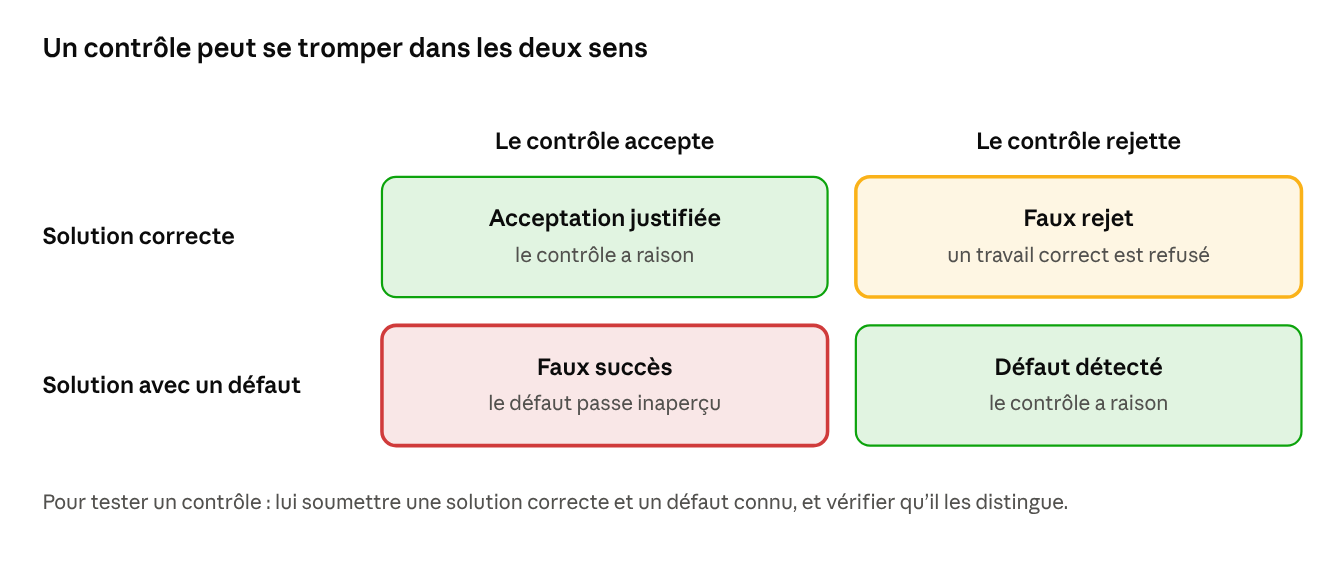
Tests, review automatique ou évaluateur : chacun de ces contrôles doit lui-même être testé.
2. Donner du contexte à l'agent
Sans contexte, un agent invente. Chez Brevo, un agent privé de la description des systèmes a imaginé des composants qui n'existaient pas.
Brevo tient donc à jour une cartographie de ses systèmes et de leurs responsables, partage son savoir-faire sous forme de skills (des instructions réutilisables que l'agent peut charger) et fait tourner ses agents sur une plateforme commune.
Sur les vieux systèmes, Alexandre Jeambrun (Octo) et Saif Jerbi (TotalEnergies) font d'abord documenter le code existant, puis font valider ces règles par les experts métier avant de générer du nouveau code.
3. Garder un outillage léger
Le harness, c'est tout ce qui entoure le modèle : instructions, skills, MCP (connecteurs vers des outils externes), contrôles. Tugdual Grall (GitHub) et Xavier Noya (Betclic) conseillent de partir d'un agent avec peu de couches et de n'ajouter que ce qui corrige un problème constaté.
Chez Betclic, les méthodes de spécification détaillée ont noyé l'équipe sous le Markdown à relire et les grosses PR, au point que les validations devenaient mécaniques.
Jean-Louis Rigau a testé l'effet d'un skill et d'une review sur 60 exécutions. Comme résultat, il y a des gains limités ou dépendants de la configuration, et un workflow installé pas toujours utilisé par l'agent.
4. Relire aussi la conversation
Marek Kalnik (Theodo) propose la Conversation Review : relire en équipe l'échange entre le développeur et l'agent, comme on relit du code. On y regarde la taille de la tâche, la façon dont elle a été menée et validée, son coût et les interventions humaines.
Dans son exemple, une question de stratégie technique a dérivé vers de l'implémentation ; c'est la relecture qui a fait apparaître ce changement de périmètre. Ces relectures débouchent sur des corrections concrètes: préciser le contexte, ajouter une compétence ciblée, améliorer un test.
5. Réduire les coûts
Pour Philippe Prados (Carbon IT), la facture dépend surtout du nombre d'allers-retours avec l'agent, du contexte renvoyé à chaque tour et de l'efficacité des outils.
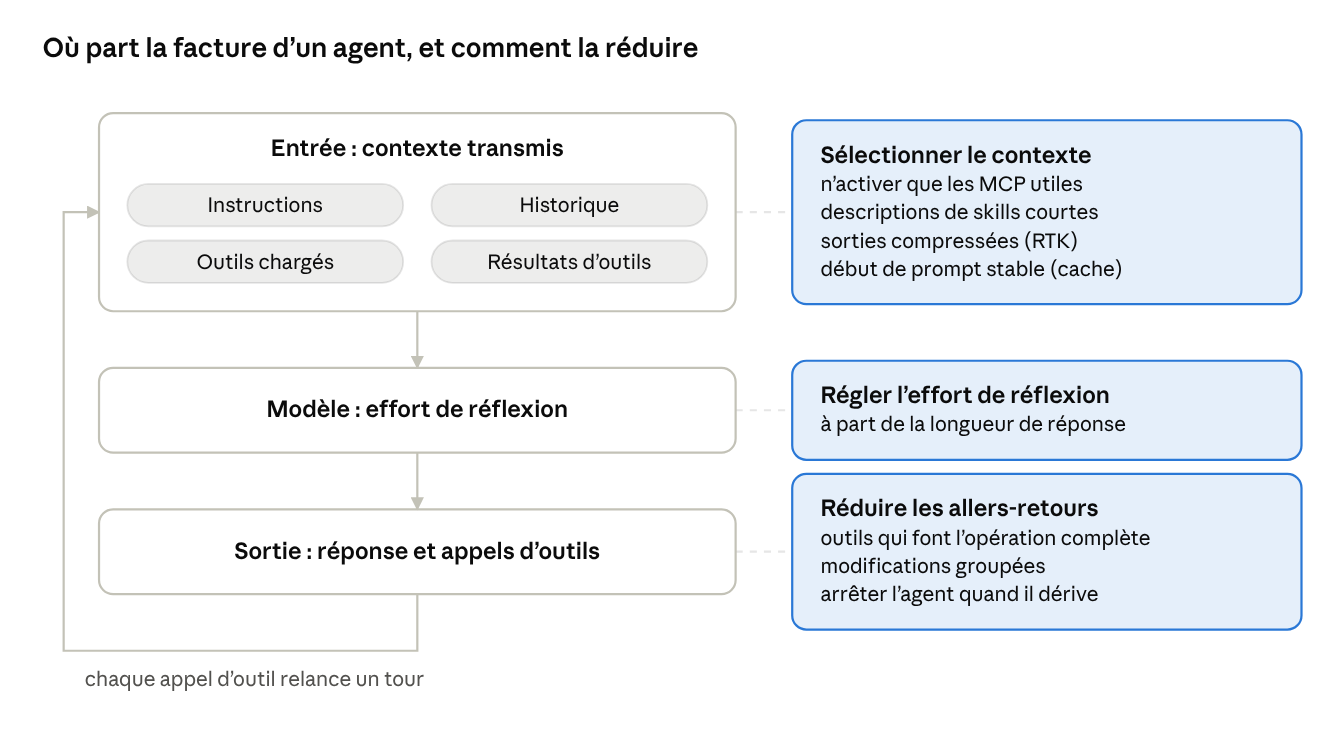
Ses conseils sont de n'activer que les MCP utiles, garder des descriptions de skills courtes, donner à l'agent des outils qui font une opération complète d'un coup (renommer via l'IDE, grouper les modifications, compresser les sorties de commandes avec RTK) et garder un début de prompt stable pour profiter du cache.
Ce qui ne fait pas consensus
Les intervenants divergent sur trois sujets, surtout parce que leurs contextes diffèrent (taille d'équipe, volume du projet).
| Sujet | Une position | L'autre position |
|---|---|---|
| Taille de la tâche déléguée |
déléguer une tâche ambitieuse
|
découper la production en microtâches
|
| Méthodes de spec détaillée (SDD, BMAD : rédiger des spécifications complètes avant de laisser l'agent coder) |
trop lourds pour l'équipe chez Betclic
|
BMAD utile en solo, entouré de ses propres contrôles
|
| Place de l'humain |
revue humaine systématique
attention humaine réservée aux changements sensibles (paiements, droits d'accès, données privées)
|
implémentation sans humain, cadrage humain en amont
|
À tester dans son équipe
Ces retours se testent avant de s'adopter : chaque outil ou pratique (skill, review, méthode de spec) s'essaie sur ses propres tâches, avec et sans, car ce qui marche pour un projet ou une équipe ne vaut pas forcément pour un autre.
Mon avis: les hooks, grands oubliés de la journée
Sur toute la journée, les hooks n'ont été cités qu'en passant, dans la démo d'Antigravity, alors qu'ils peuvent apporter un gain énorme.
Un hook est un script que l'outil qui pilote l'agent (Claude Code, par exemple) déclenche automatiquement à un moment précis: avant un appel d'outil, à la fin d'une tâche, ou quand on envoie un prompt. Ce dernier type de hook, appelé UserPromptSubmit dans Claude Code, est le plus sous-estimé. À ce moment-là, on peut ajouter au prompt exactement le contexte dont le modèle a besoin.
La différence avec un skill ou un MCP est simple. Ceux-ci sont chargés dans le contexte en espérant que le modèle pense à les utiliser, avec un résultat qui peut varier d'une fois à l'autre. Un hook, lui, s'exécute à chaque fois et donne toujours le même résultat.
Une idée d'utilisation (et je passe le bonjour à notre ami du channel slack pour son idée. (s/o Livio)) est de rendre l'envoi du contexte plus précis, plus utile en le faisant passer par un hook avant d'arriver dans son LLM.
Si le contexte utile arrive avec le prompt, l'agent n'a plus à le chercher. Ce qui donne moins d'appels d'outils, moins de tokens consommés, moins d'attente.
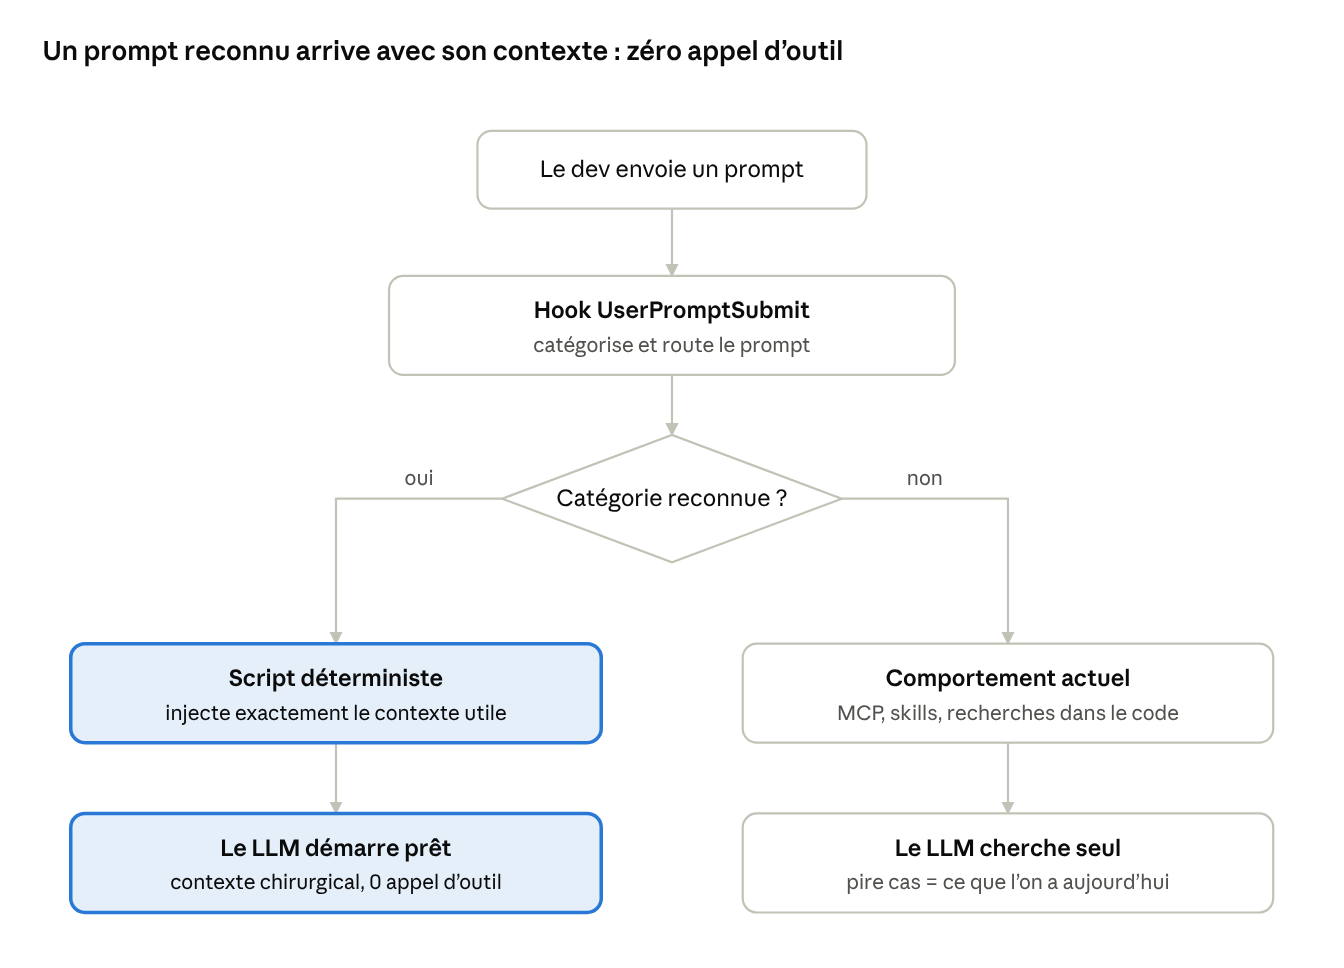
Un prompt reconnu arrive avec son contexte et dans le pire cas, on retrouve ce que l'on a déjà aujourd'hui.
Les hooks ne rendent pas les skills et les MCP inutiles du jour au lendemain. Pour savoir quoi injecter, il faut d'abord reconnaître le type de prompt, ce qui n'est pas trivial. Des outils comme Jev sont faits pour ça. Un prompt non reconnu suit le fonctionnement habituel. L'idée est de sortir des skills et des MCP tout ce qui peut être fait par un script déterministe.
Le lien avec les talks
- Jean-Louis Rigau a montré qu'un workflow installé n'est pas toujours exécuté par l'agent alors qu'un hook s'exécute à chaque fois.
- Philippe Prados recommande de sélectionner le contexte et de choisir les MCP utiles avant la conversation alors qu'un hook peut faire cette sélection automatiquement, prompt par prompt.
- RTK filtre les sorties de commandes sans faire appel au modèle. Masquer des secrets ou filtrer un résultat relève du même principe et peut tenir dans un script appelé par un hook.
Merci !
Merci à Greg Lhotellier, fondateur de Dev With AI, d’avoir organisé cette première édition et réuni la communauté au Forum des Images. Merci aussi au comité de contenu, Marek Kalnik, Laetitia Lanfranchi et Arthur Magne, qui a choisi les intervenants et les sujets. Et merci aux 16 intervenants d’avoir partagé leurs retours d’expérience!
Pour continuer les échanges plus largement, la communauté Dev With AI a un Slack ouvert à tous.
Les talks en une ligne
| Intervenant | Sujet | Ce qu'il faut en garder |
|---|---|---|
| Guillaume Laforge (Google) | Antigravity | Gestion des agents, IDE, CLI et SDK ; worktrees (copies de travail Git séparées) pour isoler les modifications, artefacts (plan, diff, captures, vidéo) pour inspecter le travail délégué. Conseil : un projet d'expérimentation, et demander à l'IA d'expliquer ce qu'elle signale. |
| Mikaël Arias, Maxence Bourquin (Brevo) | Software Factory | Contributions ouvertes entre équipes, code owners (responsables de chaque dépôt) pour l'arbitrage final. La review par agents sépare les corrections à faire des notes au mainteneur ; la revue humaine reste systématique. |
| Dorra Bartaguiz (Arolla) | Harness Engineering | Kata de calcul de dates (dates invalides, jours non ouvrés, reports) rejoué avec un parcours explicite : termes métier, exemples, stratégie de tests, TDD (écrire le test avant le code) par petits pas. Les agents autonomes ont besoin de conditions d'arrêt. |
| Marek Kalnik (Theodo) | Conversation Review | Distinguer la délégation d'exécution (objectif clair) de l'échange de conception ; une conversation ne se juge pas au nombre de messages. |
| Alexandre Jeambrun (Octo) | Usine agentique sur un SI de 30 ans | Un coordinateur distribue les tâches à des agents qui planifient, implémentent, revoient et corrigent ; une passe vérifie que les problèmes signalés existent. Contrats d'entrée et de sortie stables, merge protégé. |
| Florian Bruniaux (Méthode Aristote) | Du code au merge | Contrôles déplacés sur le poste du développeur. Review par CodeRabbit, FriendlyReviewer et un reviewer maison, doublons rapprochés ; boucles arrêtées sur objectif, budget, itérations, blocage ou désaccord. |
| Tugdual Grall (GitHub), Xavier Noya (Betclic) |
5 ans de Dev with AI | Benchmark récurrent pour comparer modèles, contextes et skills au coût du résultat obtenu plutôt qu'au volume de tokens ; ateliers et guilde interne chez Betclic. |
| Philippe Prados (Carbon IT) | La guerre des tokens | Outils chargés seulement quand l'agent en a besoin ; régler séparément modèle, effort de réflexion et style de réponse ; configuration reconstructible (fragments d'instructions, scripts d'installation). |
| Saif Jerbi (TotalEnergies) | Archéologie logicielle | Documentation générée pour les experts et validée avant l'implémentation ; l'historique d'exécution sert aux tests de comparaison ; accès aux API et aux données encadrés par des MCP. |
| Jean-Louis Rigau (Manufacture) | Nos workflows s'améliorent-ils ? | Quatre configurations comparées (agent seul, avec skill, avec review, les deux) ; l'évaluateur lui-même est testé avec une implémentation de référence, des variantes correctes et des erreurs volontaires. |
| Bathilde Rocchia (Vivace App Studio) | Son flow de création d'app en 18 mois | App Ventilate ; Figma connecté à son agent ; site sous Astro avec contenus dans le dépôt, à la place d'un CMS qu'elle n'utilisait pas. |
| Rémi Lakmeche (The One Studio) | HorseBrokers | Stack mobile qu'il ne maîtrisait pas ; brief, design, architecture et stories cadrés avant de déléguer le code ; sous-agents en parallèle sous coordination. |
| Patrick Szymkowiak (rtk-ai labs) | RTK et RTK Pro | Compression des sorties de commandes pour les agents. RTK Pro vise les équipes : coûts par projet et par développeur, politiques de sécurité, distribution des skills. Piste annoncée : laisser les utilisateurs personnaliser leurs filtres. |
| Katia Gil Guzman (OpenAI) | Apps pour humains et agents | Concevoir ses applications en traitant l'agent comme un nouveau type d'utilisateur. Le compte rendu ne détaille pas ses exemples. |