Contexte
L’IA, l’IA, l’IA… Tout le monde en parle, et avec elle, tout un tas de nouveaux termes qui reviennent sans cesse : agents, workflow, agentique, orchestrateur, et j’en passe.
Mais tout cela restait assez abstrait pour moi. Pour mieux comprendre, je voulais mettre les mains dans le cambouis et expérimenter par moi-même, tout en dépassant mon appréhension de perdre le contrôle et la maîtrise de ma base de code.
La question était simple : Est-ce qu'on peut utiliser ces fameux agents pour accélérer le développement tout en conservant une vraie compréhension de la base de code ?
Mon objectif n’était pas simplement de voir ce que Claude pouvait générer à ma place, mais plutôt d’apprendre à coder à ses côtés. Une façon de monter en compétences sur un nouveau framework, de garder la connaissance de mon code et, au passage, de donner du sens à tous ces termes que je lis et entends constamment.
Mais concrètement, comment je m’y prends ?
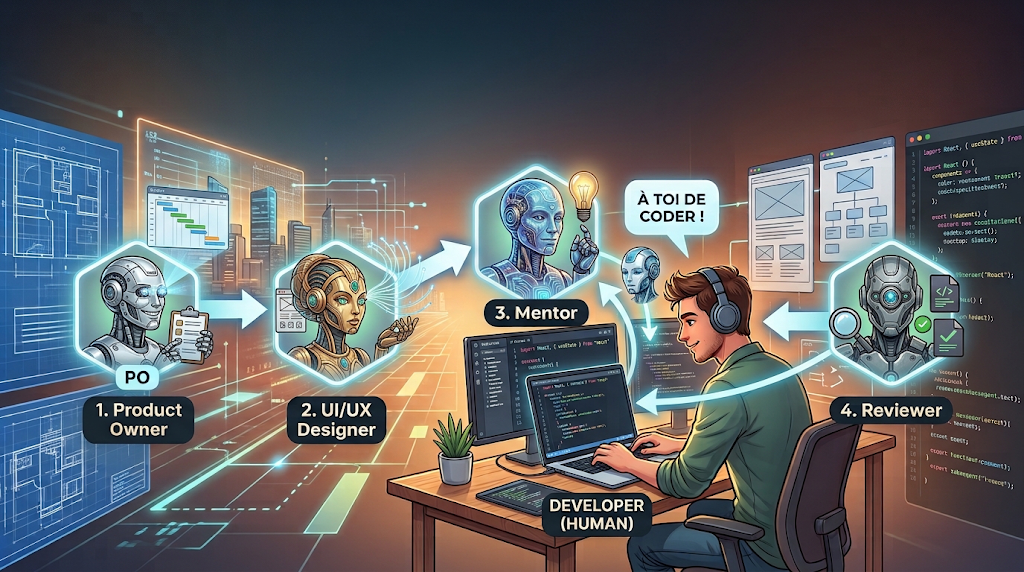
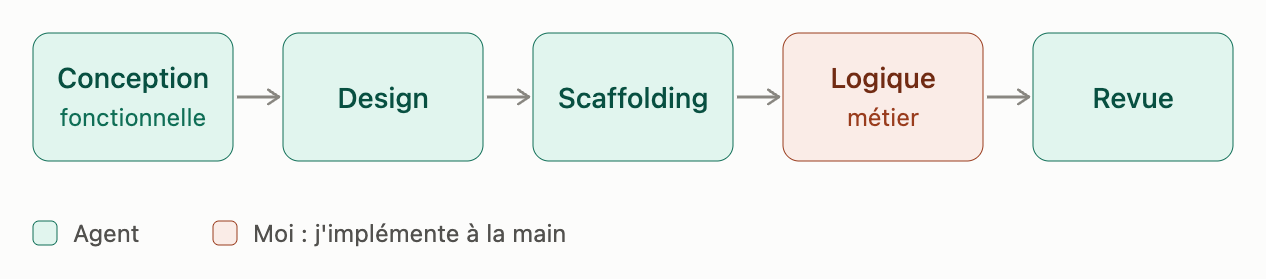
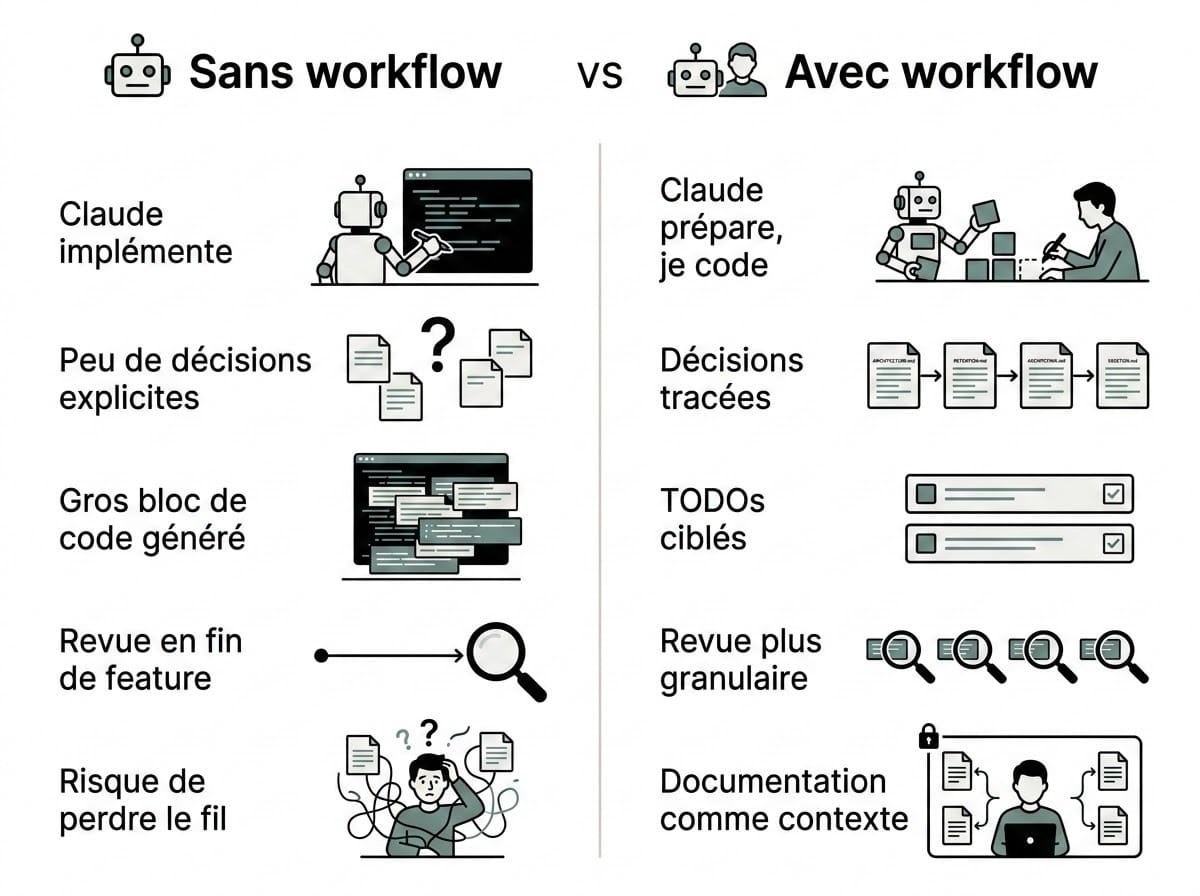
J'ai construit une pipeline de quatre agents, articulée autour de la conception fonctionnelle, du design, du scaffolding et de la revue. Entre la génération du squelette du code et sa validation, je reprends la main pour implémenter moi-même la logique métier.
Je vous propose un petit retour d’expérience sur mon workflow d’agents axé sur le mentoring m’ayant permis de développer une application PWA-first avec un backoffice sur une stack React, Vite et Supabase. Ici, la stack a peu d’importance en réalité. Je le précise pour les collègues qui liront cet article et qui ont besoin de mots clés comme ceux-ci. (Ils se reconnaîtront !)
Commençons par le commencement…
Avant toute chose, et ce, même avant l’arrivée de l’IA, j’ai pour habitude de prendre le temps de réfléchir à la conception même sur un side project afin de mieux visualiser l’étendue du travail et désamorcer des problématiques en amont de la réalisation. Par expérience, cela m’a évité bien des maux de tête !
Maintenant avec cet outil formidable qu’est Claude Code, toute cette partie conception se concentre sur l’interface web après avoir créé un projet et l’avoir décrit en 2 ou 3 phrases. Je commence par expliquer dans les grandes lignes le contexte du projet que je souhaite développer en lui donnant des instructions globales claires :
“ Tu es un mentor architecte expert dans la réalisation d'applications web en React ainsi qu'en PWA. Ton rôle principal est de m'accompagner à la réalisation du projet xxx qui est une PWA maintenable, évolutive et fiable - en devenir. Il faut que je puisse apprendre au fur et à mesure étant une développeuse Flutter - donc à l'opposé du monde du web. N'hésite donc pas à reprendre certaines notions. “
Je n’étais pas convaincue qu’avec ces quelques phrases, il me sorte le tutorat dont j’ai toujours rêvé mais, nous étions là pour expérimenter, alors expérimentons !
Par la suite, s’en est suivi de longues discussions en ping pong avec Claude Web qui ont abouti à la génération de quelques fichiers fondateurs pour l’application à venir. Ces fichiers qui serviront de fil conducteur tout au long du développement sont les suivants :
- ARCHITECTURE.md définit les grandes lignes de l'architecture technique de l'application, son organisation et les choix structurants qui guideront son développement. Il contient aussi les modèles de données de base (tables et relations principales), point de départ du schéma. L'objectif est de disposer d'une vision claire de la manière dont les différentes briques vont s'articuler entre elles.
- RETENTION-PURGE.md formalise les règles de conservation et de suppression des données. Il permet d’anticiper dès le départ la gestion du cycle de vie des données, plutôt que de traiter ces questions au fil de l’eau.
- PRIORISATION-FONCTIONNELLE.md permet de structurer les fonctionnalités selon leur priorité et leur valeur pour le projet. Une manière de distinguer ce qui est indispensable pour une première version de ce qui pourra être développé par la suite.
Ou encore ROLES-AND-PERSONAS.md étant donné que ChatGPT avait déjà généré un cahier des charges plus que complet pour le métier pur.
Les modèles de données ne sont pas figés en amont : ils se conçoivent au fil des fonctionnalités. ARCHITECTURE.md pose la base, puis, lorsqu'une feature nécessite de nouvelles tables ou des migrations, l'agent PO se charge de les définir dans le fichier de spécifications généré.
L’idée derrière ces documents n’était pas simplement de produire de la documentation pour la forme, mais bien de poser un cadre commun, aussi bien pour moi que pour Claude, afin de garder une vision cohérente du projet et de ne pas perdre le fil au fur et à mesure que le code prend forme.
Une fois tous ces fichiers générés, ils ont servi de contexte au projet et le cadre étant posé, je pouvais m’atteler à l’implémentation !
J’ai ensuite demandé à Claude Web de me préparer un prompt initial à destination de Claude Code, directement depuis mon IDE. L’objectif était de générer la structure de fichiers nécessaire pour poser les premières bases du projet, mais aussi de mettre en place quelques skills auxquels je pense naturellement, car ils reviennent régulièrement dans mes projets.
Parmi eux, le skill commit-gitmoji, qui permet de respecter une convention de commits basée sur les Gitmojis, et branch-creation, qui encadre la création des branches en suivant la convention de Gitflow.
L’idée était de ne pas repartir de zéro sur ces aspects récurrents, mais de les intégrer dès le départ à mon environnement de développement pour gagner en cohérence et en efficacité.
Le projet initialisé et cadré, il a fallu réfléchir aux agents qui pourraient m’aider à implémenter ces features une à une de manière à ce que je puisse monter en compétence sur la stack.
Les agents et leurs contraintes
Trois principes ont structuré la génération du workflow que nous verrons par la suite :
- Comprendre avant d'obtenir : je n'accepte pas un bout de code parce qu'il tourne, je dois pouvoir l’expliquer. C'est l'anti-thèse du vibe coding, cette pratique où l'on prompte, on regarde le résultat, on corrige au fil de l'eau sans jamais garder de trace de l'intention initiale.
- Traçabilité explicite des décisions différées : un point non tranché n'est jamais résolu en silence par l'IA. Il est marqué, daté, et remonte plus tard. D’ailleurs, ces décisions prises ou reportées se retrouveront respectivement dans les fichiers de spécifications ou dans DEFAUTS-A-CHALLENGER.md (je ne suis toujours pas convaincue du nom - mais on connait tous notre facilité à trouver des noms de fichiers alors ne me jugez pas)
- L'IA structure, je code: L'IA prépare la structure et le code répétitif ; je garde la main sur la logique métier, que je dois comprendre, implémenter et être capable d'expliquer. Je ne voulais pas simplement réduire le temps passé à écrire du code. Je voulais déplacer le temps passé : moins de temps sur le boilerplate, davantage sur la compréhension de React, des patterns web et de l'architecture
À ces principes s'ajoutent des contraintes transversales posées dès le début du projet, indépendamment de tout produit particulier : audit, conformité réglementaire (RGPD), réversibilité des choix techniques. Et un socle de notions à mobiliser qui dépasse largement le cas d'usage : un modèle RBAC à rôles cumulables sur un même compte ou encore une architecture en couches avec une règle de dépendance unidirectionnelle.
Une précision utile avant d'entrer dans le détail : cette expérimentation s'est déroulée pendant une fenêtre où l'offre Claude Pro incluait temporairement des crédits supplémentaires sur le point d'expirer. Je n'ai donc pas du tout suivi la consommation de tokens comme un axe de l'étude. Ça compte, parce que le workflow décrit plus bas est gourmand : trois couches à traverser, du scaffolding généré à chaque fonctionnalité, des tests en plus. Sur une session de cinq heures, je ne pouvais souvent implémenter qu’une fonctionnalité (ne mettez pas en cause ma vitesse d’implémentation - ça le faisait également en passant au auto-mode quand je n’étais pas en mode ‘learn’ - mais on en reparle plus tard), surtout s'il faut un ou deux allers-retours de revue.
Ce workflow optimise donc l'apprentissage et la maîtrise du code, pas nécessairement la vitesse brute d’implémentation.
Si vous reproduisez cette méthode dans un contexte payant standard, je vous conseillerais d’optimiser votre workflow aux petits oignons en amont.
Le workflow en détail
Maintenant que l’on a rapidement passé sous silence le bas qui blesse : le coût. Passons à l’implémentation de ces fameux agents.
La pipeline à quatre agents
J’ai défini mon besoin en quatre domaines distincts : le métier, le design, le mentoring et la revue. Ce qui a donné lieu à la génération de 4 agents :
- Un agent produit cadre le besoin et écrit les critères d'acceptation dans un fichier de spécifications dans un dossier specs/<feature-name>.
- Un agent design propose la structure de l'écran et de l'interaction en se basant sur un design donné et ajouté à un dossier designs/<feature-name>.
- Un agent mentor génère la vue complète à partir des indications du design, plus le boilerplate estimé, puis s'arrête net sur des TODOs métier explicites.
Entre cet agent mentor et l'étape suivante, c'est moi qui code. La vue et le boilerplate sont posés, mais la pipeline s'arrête volontairement avant la logique métier : c'est l'endroit où l'apprentissage a réellement lieu, et seule la partie design a été déléguée. En effet, n’étant pas fan de tout ce qui attrait de près ou de loin à des balises HTML, cette partie est délaissée. Une fois mon implémentation terminée, une seconde commande déclenche :
- Un agent de revue qui relit et critique le code que j'ai écrit, mais qui n'écrit jamais à ma place. Ses accès à l'écriture de fichiers et à l'exécution de commandes sont retirés de sa configuration (disabledTools).
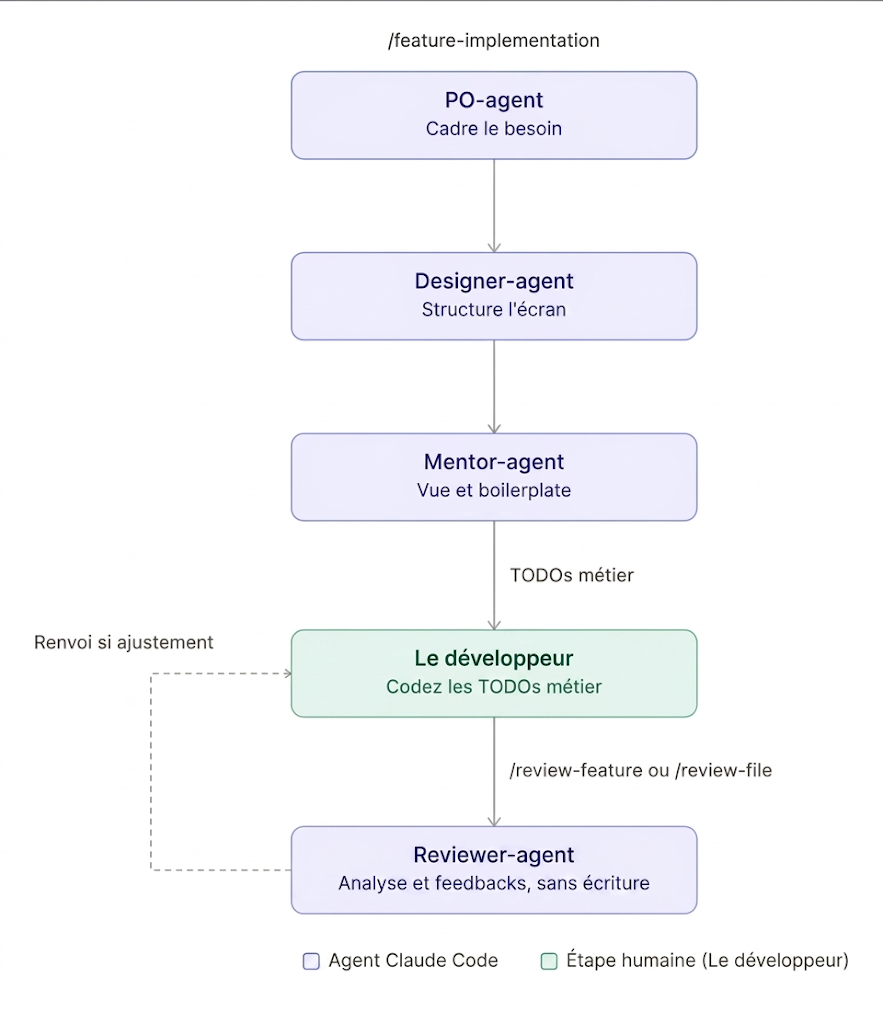
Tout ce workflow est appelé via deux commandes distinctes :
- feature-implementation pour les 3 premiers agents
- review-feature pour faire une relecture avec le dernier agent du workflow
Dans l’idée, on a :
- L’agent PO qui rédige une specs en précisant les points considérés comme ouverts et en les catégorisant comme étant bloquant ou non pour l’implémentation. Étant donné que l’IA ne prend aucune décision, l’agent peut attendre des réponses du développeur si certains points importants n’ont pas été précisés.
- C’est ensuite au tour de l’agent designer. Il prend comme référence le fichier de specs fraîchement rédigé par l‘agent PO et les designs au format png fournis pour la feature. Ces derniers sont précisés lors de l’appel du skill /feature-implementation. Il se base ainsi sur ces designs et les différentes autres contraintes d'ergonomie du projet qu’il a en contexte afin d’étoffer les specs rédigées par l’agent PO.
- Puis, vient l’agent mentor, qui lui aura toutes les billes pour réaliser le “scaffolding” de la fonctionnalité soit implémenter la partie vue comme décrite par le designer dans les specs et tout le boilerplate qu’il estime non nécessaire à la montée en compétence du développeur. Il s’agira ainsi de toutes les classes nécessaires réparties dans les couches d’architecture définie en amont avec des TODOs détaillés qui pointent vers les critères d’acceptance des spécifications rédigés en amont.
- C’est alors le tour du développeur de passer à l’action en suivant les instructions des TODOs. Pour ma part, j’ai installé un plugin pour avoir une visualisation claire de l’ensemble des TODOs du projet afin de naviguer plus efficacement dans le projet et avoir une vision globale sur ce qu’il y a à faire.
- Par la suite, le développeur peut alors lancer le skill /review-feature qui analysera l’ensemble de la fonctionnalité, à la fois en termes d’attendu métier et techniquement. Il renverra alors une liste de points bloquants ou non à corriger avant de valider la feature.
Cette mécanique s'est affinée sur plusieurs points au fil du projet.
Prenons un exemple concret
Une page d’accueil
Pour mon application, il a été question, comme beaucoup d’autres, d’une page d’accueil qui recense plusieurs informations en base de données de manière structurée selon la personne connectée. Ici, il s’agit d’un coach devant avoir une vision sur la “santé” de son équipe.Pour cela, voici le cheminement qui a été fait :
- Conception du design via Claude design
- Import du design au format PNG dans le projet (docs/designs/homepage_admin)
- Lancement du skill /feature-implementation avec quelques détails
/feature-implementation homepage_admin. This dashboard should display core information as designed in @docs/designs/homepage_admin. By clicking on cards, the user should be redirected to the associated detailed page. Do not display the red alert card yet.
- Le workflow se lance et chaque agent peut être amené à me demander des précisions sur des choses lui paraissant bloquantes.
- L’agent PO rédige les spécifications tel que specs/homepage_admin.md en précisant les critères d’acceptance mais aussi les différents points ouverts non bloquants ou résolus
- L’agent designer prend le relai en étoffant cette documentation avec des détails de design et de workflow utilisateur
- L’agent mentor commence alors le squelette de la feature en implémentant la vue, et les différents boilerplate nécessaire présent sur chaque couche précisées dans le document d’architecture. Un des TODOs générés concernait la redirection vers le calendrier des évènements à venir géré au niveau du viewModel :
goToCalendar: () => {
// TODO: Calendrier route doesn't exist yet — replace once that
// feature lands (AC-CD-08 "Voir tout" → Calendrier).
// navigate('/calendar/{convocation.date}')
},
- J’implémente les différents TODO
- Je demande une revue de la feature implémentée via le skill /review-feature.
- Et enfin, je lance le skill de génération des commits en demandant simplement à Claude de les générer.
L’évolution de la pipeline
Au fur et à mesure, je me suis rendu compte que certains points du workflow n’étaient pas optimaux pour l’usage que je voulais en faire. Il a fallu ainsi les retravailler pour qu’ils soient les plus pertinents possible.
La granularité de la revue
Sur ce dernier point, je me suis rendue compte qu’à l’usage qu'il était beaucoup plus pertinent d’avoir une revue par fichier (en ayant le contexte global) qu’une fois l’ensemble de la feature implémentée. Cela m’a permis d’avoir des feedbacks beaucoup plus réguliers.
Le choix conscient du niveau de délégation
La pipeline décrit plus haut correspond à ce que j'appelle le mode « learning » : l'agent mentor s'arrête aux TODOs métier et je les code moi-même.
Pour vérifier cette pipeline en “auto mode” et ainsi voir la pertinence des agents sans intervention humaine, j’ai ajouté des arguments au skill /feature-implementation qui permet de choisir le mode “learning” et sinon, le mode par défaut choisira l’agent ‘implémenter” plutôt que l’agent mentor pour coder la feature au lieu d’écrire des TODOs. C'est un point que je n'ai pas fini de creuser, j'y reviens plus bas parce qu'il ouvre une vraie question de gouvernance.
Le sort des maquettes
J'ai testé de référencer les designs générés via l'outil de design de Claude par de simples liens plutôt que par des fichiers stockés dans le repo. L'idée était séduisante sur le papier : une source vivante plutôt qu'un dossier de designs figés. Je l'ai vite abandonnée car un design accessible par lien n'offre pas de “snapshot” figé dans le temps : s'il est modifié, l'agent perd sa source de vérité et tout l'historique de ce qui avait été validé auparavant. À l'inverse, importer les maquettes en image dans le repo est plus rébarbatif à chaque itération, mais chaque import est un snapshot daté, versionable comme n'importe quel autre fichier.
Entre une source de vérité qui peut être amenée à être modifiée ou supprimée et une image un peu pénible à réimporter mais stable, j'ai choisi la stabilité.
D'autres frictions
J’aime échanger des décisions globales au projet comme l’architecture ou encore des scénarios métiers précis via l’interface web, laissant ainsi l’implémentation côté CLI Claude Code directement via mon IDE. Cette pluralité d’interface a, au début, engendré des différences notables car le contexte n’était pas forcément complet dans ces situations là. Pour éviter cela, lorsque je passe par Claude Web pour ce genre de discussion, je le laisse générer un prompt récapitulatif pour éviter la perte d’informations cruciales côté CLI.
Ce qui reste à challenger
Trois points n'ont pas de réponse satisfaisante à ce stade, et je préfère les nommer plutôt que de laisser croire que la méthode est bouclée.
Le destinataire réel de la documentation implicite
Les fichiers d'architecture, de gouvernance, de rétention, et les specs par fonctionnalité s'adressent-ils à une personne qui lira, ou à un agent qui exécutera ? Le fichier de spec, en particulier, reste très long à ce stade, et la question de son lecteur principal n'est pas tranchée. Ce n'est pas propre à ce projet : c'est une tension centrale de tout ce qui se revendique du spec-driven development, cette pratique consistant à rédiger une spécification structurée avant de laisser un agent générer du code, en la gardant comme source de vérité pour les humains comme pour les agents. Le problème, c'est que le niveau de détail optimal pour un humain qui doit comprendre l'intention et celui qui sert le mieux un agent qui doit l'exécuter ne coïncident pas forcément.
Le risque de contournement du mode apprentissage
Rien, techniquement, n'empêche de demander dans une autre session à un agent d'implémenter directement les TODOs métier laissés par l'agent mentor, ce qui irait à l’encontre même de l’objectif pédagogique de cette pipeline. C'est un point à creuser sérieusement si l'on veut un environnement réellement contraint plutôt qu'une convention de bonne volonté : retirer les permissions d'écriture de l'agent mentor en dehors d'un mode explicitement choisi, bloquer un commit qui n'est pas passé par la revue par fichier, ou toute autre garde-fou technique plutôt que déclaratif. Pour l'instant, la seule protection est la discipline de la personne qui code.
Le biais de l'expérimentation elle-même
Comme évoqué en introduction, cette méthode a été testée sans contrainte de tokens, dans une fenêtre de crédits temporaires. Le rapport coût/bénéfice réel, en usage payant standard et sur la durée, reste à mesurer avant de recommander la méthode telle quelle à une équipe qui code sous contrainte de budget.
Pour conclure, j’ai réellement apprécié avoir l'impression de coder de pair avec l’IA en mode mentor. Je suis montée en compétence sur ces technos et j’avais une vraie connaissance de la base de code contrairement au mode par défaut qui implémente tout sans passer par une intervention humaine. Néanmoins, il reste encore à trouver un juste milieu entre ces deux modes. L’un demanderait à avoir plus de garde-fou pour éviter de compter sur la bonne foi du développeur et l’autre, sur une meilleure connaissance du code en ajoutant des contraintes sur ce que peut et ne peut pas faire l’agent implementer.
En gros,
Plus je délègue à l'IA, plus je gagne en vitesse.
Moins je délègue, plus je conserve la maîtrise.
Mon expérimentation consistait finalement à chercher le point d'équilibre entre les deux.
Je n’ai pas encore trouvé cet équilibre mais j’ai beaucoup appris.
Par la suite, on pourrait bien sûr imaginer approfondir le workflow et aller jusqu’au déploiement d’un livrable. Ce n’était pas l'objectif de cette expérimentation mais l’idée reste pertinente.
Pour aller plus loin
- Documentation officielle des sub-agents Claude Code, sur le fonctionnement des contextes isolés et la restriction d'outils par agent : docs.claude.com/en/docs/claude-code/sub-agents
- Sur le spec-driven development et sa tension avec le vibe coding, je vous laisse sur l'article de Julien Pérez: https://fr.linkedin.com/pulse/vibe-coding-et-spec-driven-development-julien-perez-e9xwe