Intro : l'IA ne tue pas le Platform Engineering, elle le rend indispensable
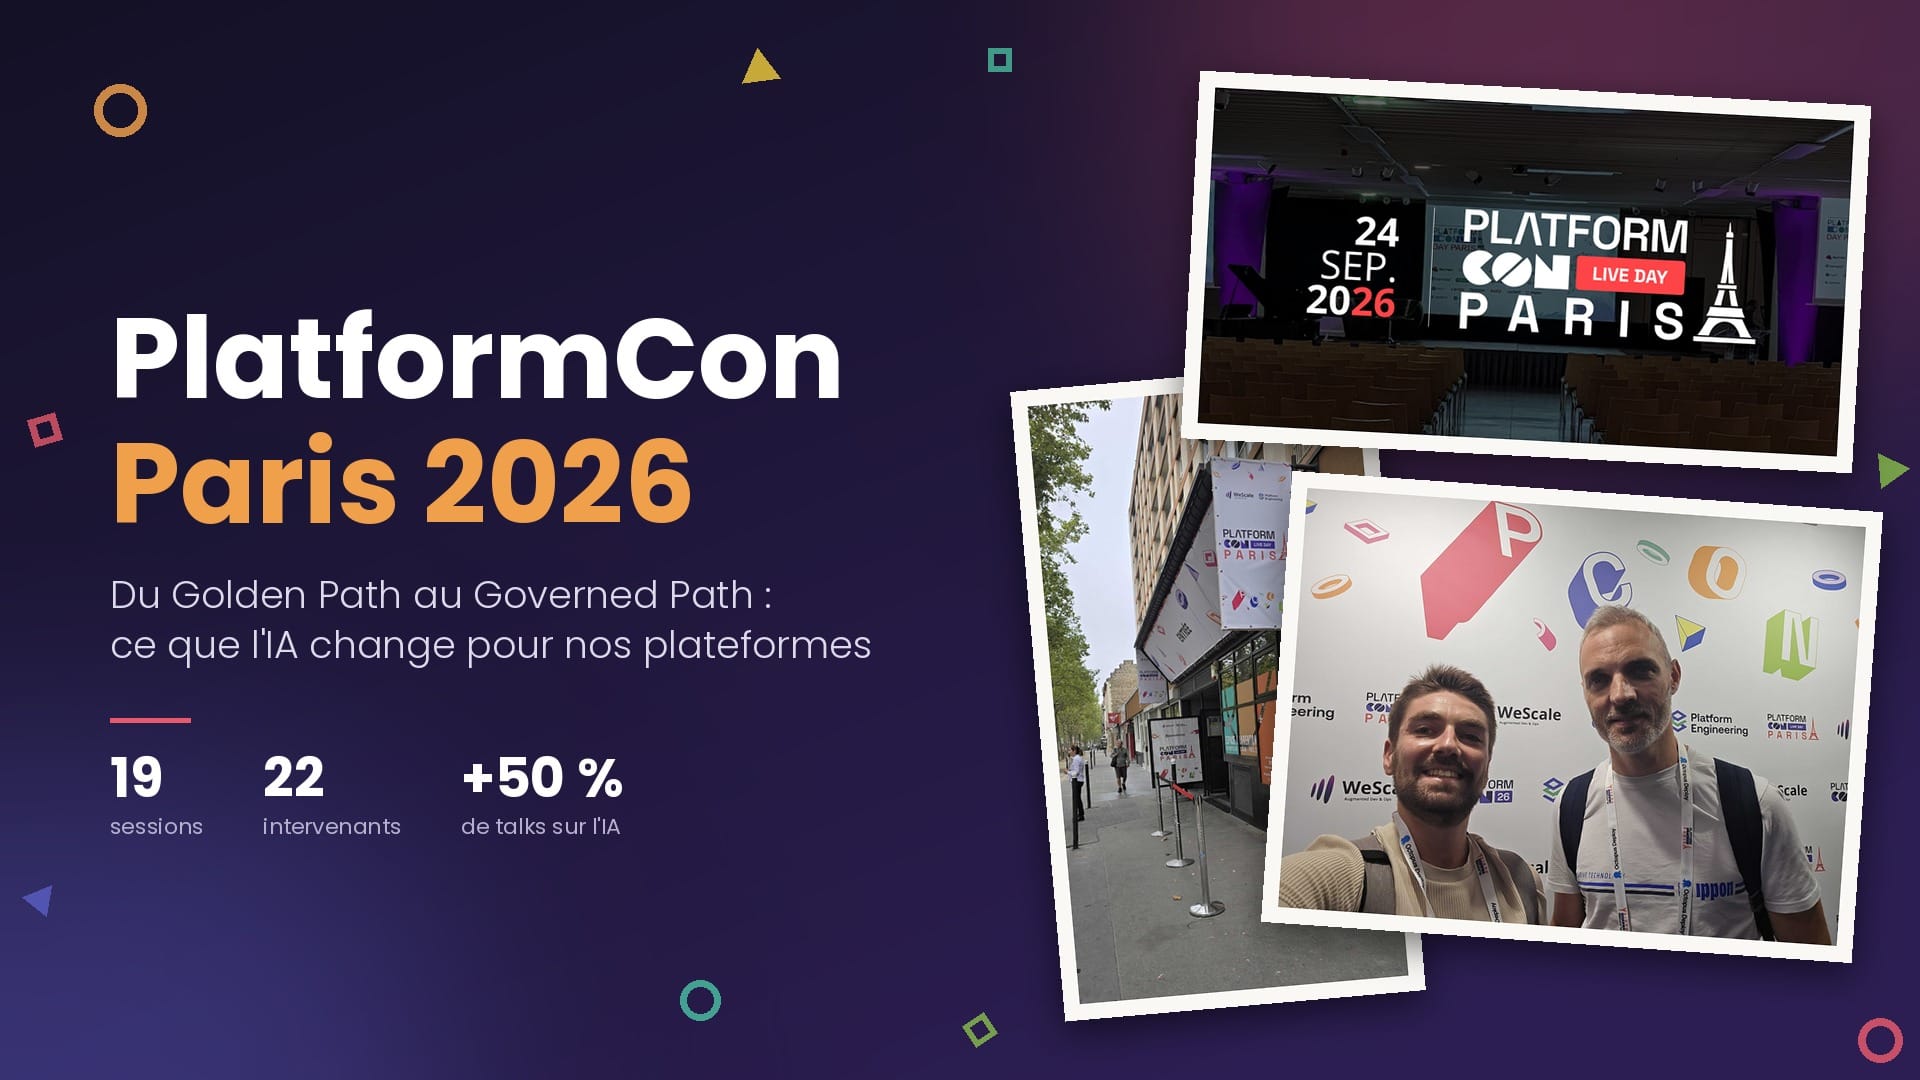
Le 24 septembre 2026, la communauté Platform Engineering s'est retrouvée à Paris pour la deuxième édition de la PlatformCon, co-organisée par PlatformEngineering.org et WeScale. Une journée particulièrement intense avec une idée claire qui revenait dans quasiment toutes les présentations: l'arrivée massive des agents IA a complètement déplacé le problème.
Au départ, la promesse du Platform Engineering était plutôt simple : soulager la charge mentale des développeurs avec du self-service, des Golden Paths bien balisés et des portails internes (IDP). Sauf qu'aujourd'hui, les agents IA génèrent des lignes de code plus vite qu'on a le temps de les relire. Du coup, le vrai sujet n'est plus du tout de réussir à produire plus de code, mais d'avoir suffisamment confiance dans ce qui sort pour pouvoir l'envoyer en production sans trembler.
Nous vous proposons un petit tour d'horizon des retours d'expérience marquants de la journée, croisés avec les enseignements des derniers rapports State of Platform Engineering, pour bien comprendre la réalité du terrain en 2026.
Les 6 grands enseignements de la journée
Pour planter le décor, la clôture de WeScale a résumé l'événement en quelques chiffres : 19 talks, 22 speakers, 18 entreprises représentées, et plus de la moitié des sujets centrés sur l'IA. Voici les 6 leçons majeures à garder en tête.
1. Shift Down plutôt que Shift Left
Red Hat a ouvert le bal avec une vérité qui parlera à beaucoup d'entre nous : le fameux « Shift Left » prôné par le DevOps a fini par transmettre toute la complexité opérationnelle sur les épaules des développeurs. Résultat direct : fatigue cognitive, dette technique accumulée et ralentissement global sur la sécurité.
Et forcément, l'IA accélère encore la cadence. Red Hat recensait déjà 35 000 CVE publiées cette année, avec une trajectoire qui pointe vers les 70 000 d'ici la fin de l'année. Leur conviction ? Il faut passer au Shift Down. Concrètement, la sécurité, la conformité et la gouvernance doivent directement être gérées au niveau de la plateforme, de manière totalement transparente pour les équipes produit, grâce à des architectures et des pipelines validés d'office.
VMware a enfoncé le clou lors de leur présentation sur le « Platform Engineering 2.0 ». Pour eux, Shift Left et Shift Down ne s'opposent pas, ils se complètent : le premier attrape les soucis en amont, le second s'occupe du reste et vérifie la conformité en continu sur les environnements actifs. Avec l'IA, de nouveaux risques débarquent (shadow AI, prompt injection, empoisonnement de modèles, fuites de données au moment de l'inférence). La solution n'est sûrement pas de rajouter encore des outils aux dévs, mais de renforcer le niveau de sécurité natif de la plateforme.
2. Les agents IA deviennent des utilisateurs de la plateforme
Luca Galante (PlatformEngineering.org) a résumé la situation : de 2020 à 2025, la préoccupation principale était « sur quoi tournent les développeurs ? ». En 2026, la vraie question devient « sur quoi tournent les agents ? ». Et la réponse reste exactement la même : la plateforme.
Les profils d'utilisateurs qui consomment la plateforme continuent de se diversifier : développeurs logiciels, data scientists, équipes métiers, et désormais agents autonomes. Problème : le premier frein remonté sur le terrain est la « Platform Readiness » (la plateforme n'est tout simplement pas taillée pour ces nouveaux usagers). Une bonne plateforme joue normalement un rôle de multiplicateur d'efficacité ; avec l'IA, ce multiplicateur devient carrément exponentiel.
Manuel Pais (co-auteur de Team Topologies) est revenu sur la manière de repenser les interactions en ajoutant les agents IA à l’équation. En effet, un agent qui modifie une partie du système, sans regard sur l’environnement autour, peut introduire des effets de bord, et dégrader le système dans son ensemble.
Dans Team Topologies, on retrouve 3 modes classiques entre humains : collaboration, « X as a Service » et facilitation. Mais un agent n'a pas d'intention propre ou de recul : il cherche juste à exécuter une consigne, et la collaboration humaine est beaucoup trop lente pour son rythme. Sa préconisation :
- privilégier massivement le mode « X as a Service » pour les agents (qu'ils puissent consommer des services sans nécessiter de coordination, trop lente) ;
- s'assurer que les humains (côté Plateforme et Produit) définissent un cadre clair en amont : degrés d'autonomie, niveau de risque toléré, traçabilité en utilisant la collaboration;
- poser des gardes-fous bien dosés, et surtout descriptifs plutôt que prescriptifs (en gros, fixer l'objectif à atteindre plutôt que d'imposer chaque étape de l'exécution).
3. Passer du Golden Path au Governed Path
C'était sans doute la session technique la plus poussée de la journée (2 h 30). Stéphane Teyssier (Solario) a démarré sur un constat simple : le Platform Engineering outille très bien l'infra, les pipelines CI/CD, l'observabilité et le bootstrapping d'applications. En revanche, la phase de spécification reste encore très artisanale (cérémonies agiles, refinement, doc rédigée à la main). Si un copilote de code accélère le développement pur, une usine véritablement augmentée doit remonter plus haut dans la chaîne, là où le temps s'évapore vraiment.
Une phrase marquante à retenir : « Si tu n'es pas le modèle, tu es le harness. » Il découpe l'architecture en 3 niveaux : l'inférence (le LLM), le harness agentique (l'agent au travail) et l'AI Delivery Control Plane (la couche de contrôle qui vérifie l'action de l'agent). C'est cette dernière couche qui traduit des intentions fonctionnelles en portes de validation indiscutables.
Concrètement, l'usine Solario enchaîne quatre phases gouvernées :
- Intent : le besoin est formalisé dans un PRD, signé par un humain.
- Design : le PRD est découpé en spécifications (spec.md) et en tâches (tasks.md).
- Build : l'agent produit le code et les tests.
- Test / Audit : des contrôles automatiques vérifient le résultat et produisent un dossier de preuve.
- Merge : le code n'est intégré que si la preuve est complète.
Chaque étape intègre ses propres garde-fous et boucles de vérification. Trois grands principes ressortent :
- Garder du déterminisme au maximum. Tout ce qui peut être validé programmatiquement doit l'être (syntaxe, typage, architecture, gates bloquantes). Le modèle de langage n'est sollicité que lorsqu'une analyse de contexte fine est vraiment indispensable. Sur 111 contrôles dans leur usine, une seule catégorie s'appuie sur de la vérification non-déterministe.
- Livrer du code + le dossier de preuve associées. Rien ne rentre sur la branche principale sans son dossier de preuves complet.
- Un ADR sans validation automatique reste un vœu pieux. Une décision d'architecture ne s'impose que si elle est adossée à une règle d'exécution automatisée. Sinon, « l'IA sans cadre enfonce toutes les portes ouvertes ».
Dans cette approche, l'humain n'intervient plus qu'à 3 moments stratégiques : pour valider l'intention de départ, relire la spécification, et valider avant le merge final. L'usine logicielle (build-time) et l'IDP (run-time) se complètent parfaitement : l'IDP remonte les signaux du terrain, et l'usine se charge d'exécuter. Si un SLO plante en prod, il génère directement une nouvelle intention gouvernée dans le flux.
4. Le bon niveau d'abstraction compte plus que l'outil
Doctolib a livré un retour d'expérience très pragmatique. Suite au découpage de leur monolithe historique en microservices, l'équipe plateforme a dû repenser entièrement la création et le déploiement de nouveaux services. Il y a un an, il fallait compter 40 pull requests et 3 semaines de travail pour sortir un service. Aujourd'hui, on passe à 10 PR, 3 heures, et 90 % des modifications d'infra sont gérées en autonomie par les équipes applicatives. Résultats : alors qu'ils visaient 30 nouveaux services au départ, ils en ont livré 57 dans un premier temps, et en gèrent désormais 113 au quotidien.
Ce qu'il faut en retenir : le débat de savoir s'il faut utiliser Terraform, Helm ou Kubernetes manque la vraie question. Ce qui fait toute la différence, c'est le niveau d'abstraction mis à disposition des équipes. Leurs partis pris :
- Un point d'entrée centralisé : des descripteurs YAML par environnement, pilotés derrière par Terraform Enterprise et ArgoCD.
- Des conventions fortes (convention over configuration) : ajouter une base Postgres se déclare sans devoir spécifier des dizaines de paramètres.
- Des propriétés réservées gérées par la plateforme et la sécurité, pour garder la maîtrise des coûts et de la résilience.
- Valider en amont plutôt que corriger après coup : des contrôles métier appliqués dès le poste local et en CI pour tuer les erreurs avant la prod.
Ils assument aussi leurs défis actuels : la lutte permanente contre l'envie de rajouter des options (« et c'est encore pire avec Claude qui en génère plein ») et la négociation continue avec les équipes pour trouver le meilleur tradeoff. Également le fait qu'avoir tous les fichiers au même endroit recrée une forme de monolithe. Leur conviction : un fichier YAML structuré reste l'interface idéale pour échanger avec un LLM.
Sur la partie migration, Sunny Hwang (Google) est venu présenter GKE Agentic Migration, un projet open source pensé pour basculer d'EKS vers GKE. On retrouve une recette similaire : l'IA effectue le travail de conversion, des validateurs déterministes prennent la main sur les contrôles (terraform validate, vérification de manifestes), les secrets restent bien au chaud sur la machine locale, et tout passe par des pull requests validées par un humain. Jamais d'action directe sur le cluster.
L'atelier FeatureOps animé par Wojtek Gawroński (Unleash) a complété la vision côté déploiement. Comme l'indique le dernier rapport DORA, la stabilité de la prod tend à baisser au mesure que l'adoption de l'IA augmente. La parade préconisée : encapsuler systématiquement chaque changement généré par de l'IA dans un feature flag, faire du déploiement progressif, automatiser le rollback en fonction de la télémétrie de prod, et gérer rigoureusement le cycle de vie de ces flags. Le filet de sécurité fait partie intégrante du Golden Path.
5. La plateforme est un produit, avec un P&L
Peaksys (la filiale tech de Cdiscount) a partagé le retour d'expérience de 5 ans de travail sur leur plateforme d'observabilité. Le contexte : 95 % des serveurs hébergés on-premise, plus de 5 000 machines, 2 000 microservices, et un déploiement en prod toutes les 7 minutes. Au départ, ils géraient des bouts de plateforme de manière informelle « au fil de l'eau ». Ils ont fait le choix de monter une équipe dédiée de 6 personnes, sont passés de 300 000 à 3 millions de métriques collectées chaque seconde, et se sont appuyés sur OpenTelemetry pour lier métriques, logs et traces.
Trois conseils majeurs à retenir pour toutes les équipes plateforme :
- Piloter par l'usage plutôt que par la donnée brute. Ce qui compte, c'est l'exploitation réelle qu'on en fait. Et faire que la plateforme soit adoptée par les utilisateurs.
- Prévoir la sortie dès le début : anticiper le coût de migration, la réversibilité et ce qui se passe le jour où on change d'outil.
- Le principal frein est humain et organisationnel. Une bascule manquée qui dégrade les temps de réponse fait perdre instantanément la confiance des équipes. Et le tracing applicatif n'a de valeur que si l'ensemble de l'écosystème s'y met : c'est un projet d'entreprise à porter au niveau de la DSI.
La suite pour eux ? Mettre en place un serveur MCP par brique (logs, traces, métriques, Grafana) pour donner de la visibilité directe aux agents IA.
VMware s'est aligné sur ce discours : traiter la plateforme comme un produit d'entreprise, avec un P&L, un calcul de ROI et un sponsor exécutif. La démarche FinOps y devient native (coût de chaque déploiement identifié, gardes-fous de dépense avant d'envoyer en prod, pilotage des coûts des tokens IA) au lieu d'être traitée après coup. Une stat marquante citée pendant leur session : l'utilisation moyenne des processeurs dépasse à peine les 8 % sur les workloads Kubernetes dans le cloud public.
6. La sécurité : rien de neuf, sauf l'exigence
Pablo Lopez (Head of Platform Engineering chez PayFit) a abordé le sujet des attaques sur la supply chain à l'ère des assistants IA. Son constat est très net : l'IA ne réinvente pas les fondamentaux de la sécurité, ce sont les mêmes règles depuis 20 ans. Par contre, elle augmente considérablement la vitesse requise. La vitesse d'exfiltration des données impose de réagir dans la minute. Il faut élever son niveau d'exigence sur l'ensemble de la chaîne : identification, inventaire, supervision, confinement, éradication, analyse et prévention.
Quelques démarches très concrètes à appliquer : placer des kill switches à tous les étages (exemple : pouvoir bloquer le droit de merge à tout moment), appliquer une période de rétention sur l'adoption des nouvelles versions de paquets, injecter des honey tokens pour détecter les exfiltrations à la volée, attribuer une identité propre et isolée à chaque agent/sous-agent, et tenir à jour un AIBOM (cartographie des modèles et agents en place) en complément du SBOM classique. Et surtout : s'entraîner régulièrement avec des exercices de crise et du red teaming automatisé par IA.
Une autre présentation portait sur la gestion des vulnérabilités (CVE) via une évaluation du risque contextuel (basée sur le framework OWASP) : exposition directe sur internet, présence de données sensibles (RGPD, PCI DSS), criticité métier. Deux apps touchées par la même faille n'auront pas le même niveau de priorité. On ne traite que ce qui est réellement exploitable dans le contexte, ce qui évite le traitement manuel épuisant. L'outil Vens (open source) s'interface très bien avec Trivy sur ce sujet.
Ce que disent les chiffres
Les échanges de la journée font écho aux conclusions des deux dernières études de PlatformEngineering.org : le State of Platform Engineering Vol. 4 (fin 2025, 518 répondants) et le State of AI in Platform Engineering Vol. 2 (réalisé entre avril et août 2026 auprès de 350 professionnels).
L'IA s'est généralisée, mais le gain réel dépend de votre plateforme. Fin 2025, 89 % des ingénieurs utilisaient déjà l'IA quotidiennement, 94 % des boîtes la considéraient comme structurante pour l'avenir du Platform Engineering, et 86 % estimaient que la plateforme est le passage obligé pour en tirer de la vraie valeur. Le rapport DORA 2025 confirme d'ailleurs qu'une plateforme interne performante fait partie des piliers majeurs pour démultiplier les retours de l'IA.
Le ralentissement s'est déplacé de la rédaction à la validation. En 2026, 38 % des équipes déclarent livrer au moins deux fois plus vite. Mais 35 % se contentent toujours d'une relecture humaine manuelle pour vérifier le code généré, et à peine 17 % disposent de boucles de validation automatisées. On retrouve parfaitement l'analyse de Solario : la génération de code s'est industrialisée, mais pas sa vérification.
Déployer des agents ne suffit pas, il faut repenser l'architecture globale. L'étude propose une grille de lecture par niveaux de maturité agentique. C'est au niveau 3 qu'on observe un véritable saut de productivité, là où la chaîne complète (code, revue, tests) s'appuie sur des chemins gouvernés et exécutables par les machines :
Niveau de maturité agentique | Part ayant au moins doublé son débit |
Niveau 1 – IA assistante, humain qui exécute | 30 % |
Niveau 2 – premiers agents dans la chaîne | 36 % |
Niveau 3 – chemins gouvernés code + revue + test | 60 % |
Niveau 4 – agents autonomes dans un cadre | 79 % |
Rajouter simplement des agents fait gagner 6 points de débit ; repenser la plateforme en profondeur apporte un gain de 24 points. Petite précision qui a son importance : 13 des 14 organisations situées au niveau 4 comptent moins de 100 ingénieurs.
La plateforme est devenue le principal goulot d'étranglement. Interrogés sur les freins à l'adoption de l'IA à l'échelle, les répondants placent la platform readiness tout en haut (27 %), devant la maîtrise des coûts (23 %) et la capacité de revue (16 %). La performance pure des modèles ne pointe qu'en 4e position (11 %). En clair : le problème n'est plus la puissance des modèles.
La gestion des identités des agents reste un gros point noir. Un quart des entreprises font tourner leurs agents avec des accès d'utilisateurs humains, 12 % s'appuient sur des comptes de service partagés, et 18 % avouent ne pas savoir comment le sujet est géré chez elles. Le conseil de PayFit de donner une identité propre à chaque agent est donc plus que jamais d'actualité.
La base d'utilisateurs s'élargit fortement. Les données partagées par Luca Galante illustrent bien ce glissement : équipes de dév (79 %), data (49 %), métiers (48 %), et agents autonomes (29 %). 43 % des répondants voient ainsi le rôle d'ingénieur plateforme évoluer vers plus de gouvernance et de conception de garde-fous. Le rapport conceptualise ce modèle sous le nom d'Agentic Engineering Platform (AEP) : un IDP capable d'interagir directement avec des agents en leur garantissant 4 piliers : du dispatch efficace, des boucles de validation solides, une identité propre et des environnements d'exécution étanches.
Ne pas oublier les fondamentaux. Le Vol. 4 rappelait que près de 30 % des équipes plateforme ne mesurent toujours pas leur impact, et que l'usage de la plateforme reste plus souvent subi (36,6 %) que spontané (28,2 %). Leurs recommandations restent très concrètes : traiter la plateforme comme un produit avec un Product Manager dédié, sortir un MVP rapidement, viser des Golden Paths qui couvrent 80 % du besoin, et rester très proche des retours terrain. Doctolib et Cdiscount en sont de très bons exemples.
Conclusion : ce qui change pour le Platform Engineering en 2026
Pour conclure la journée, la dernière intervention a rappelé que « L'IA rebat complètement les cartes du Platform Engineering ». En pratique, ce qu'on retient surtout de cette édition, c'est que l'IA agit comme un puissant révélateur. Les bases du métier ne changent pas, mais le niveau d'exigence explose. On peut résumer ces transformations en 6 grands basculements :
Jusqu'ici | En 2026 | |
Le problème à résoudre | Produire plus vite | Faire confiance à ce qui est produit |
Le chemin proposé | Golden Path : conformité par convention | Governed Path : conformité prouvée par des gates |
Les utilisateurs | Les développeurs | Développeurs, data, équipes métier… et agents IA |
La sécurité | Shift Left, portée par les devs | Shift Down, intégrée à la plateforme |
Le périmètre | Infra, CI/CD, observabilité | Jusqu'à la spécification, en amont du code |
Le pilotage | Un projet technique | Un produit avec P&L, ROI et sponsor |
Comme le soulignent fort bien les études récentes, le succès de l'IA ne dépend pas de l'arrivée d'un modèle plus performant, mais de la solidité de l'écosystème qu'on bâtit autour. En 2026, le Platform Engineering ne cherche plus seulement à simplifier la vie des équipes : il s'impose comme le socle indispensable pour déployer une IA sûre, efficace et vraiment digne de confiance.
Sources
- Notes personnelles, PlatformCon Paris, 24 septembre 2026 (Red Hat, Luca Galante, Manuel Pais, Solario, Unleash, Doctolib, Google, VMware by Broadcom, Peaksys/Cdiscount, PayFit, clôture WeScale)
- State of Platform Engineering Report, Vol. 4, PlatformEngineering.org / Weave Intelligence, 2025
- State of AI in Platform Engineering, Vol. 2, PlatformEngineering.org / Weave Intelligence, 2026