Ippon Technologies était présent à la 2e édition de Nantes Craft. Une nouvelle fois merci aux organisateurs pour ces conférences très intéressantes. On vous résume ici quelques conférences qui ont retenu notre attention.
De pionnières à invisible, où sont passées les femmes ?
par Chloé Masse - Linkedin
Pour démarrer cette nouvelle édition de Nantes Craft, Chloé est invitée à parler de l’invisibilisation des femmes tout au long du développement de l’informatique. En remontant le temps, elle met en lumière des femmes qui ont été oubliées ou dont leur rôle a été (volontairement ?) diminué au profit d’hommes. Ainsi, elle mentionne que déjà au XIXème siècle avec les Harvard computers, les femmes, considérées comme de la main d'œuvre très bon marché, étaient pionnières dans les opérations de calcul et de traitement de données en calculant des positions d’étoiles pour des astronomes.
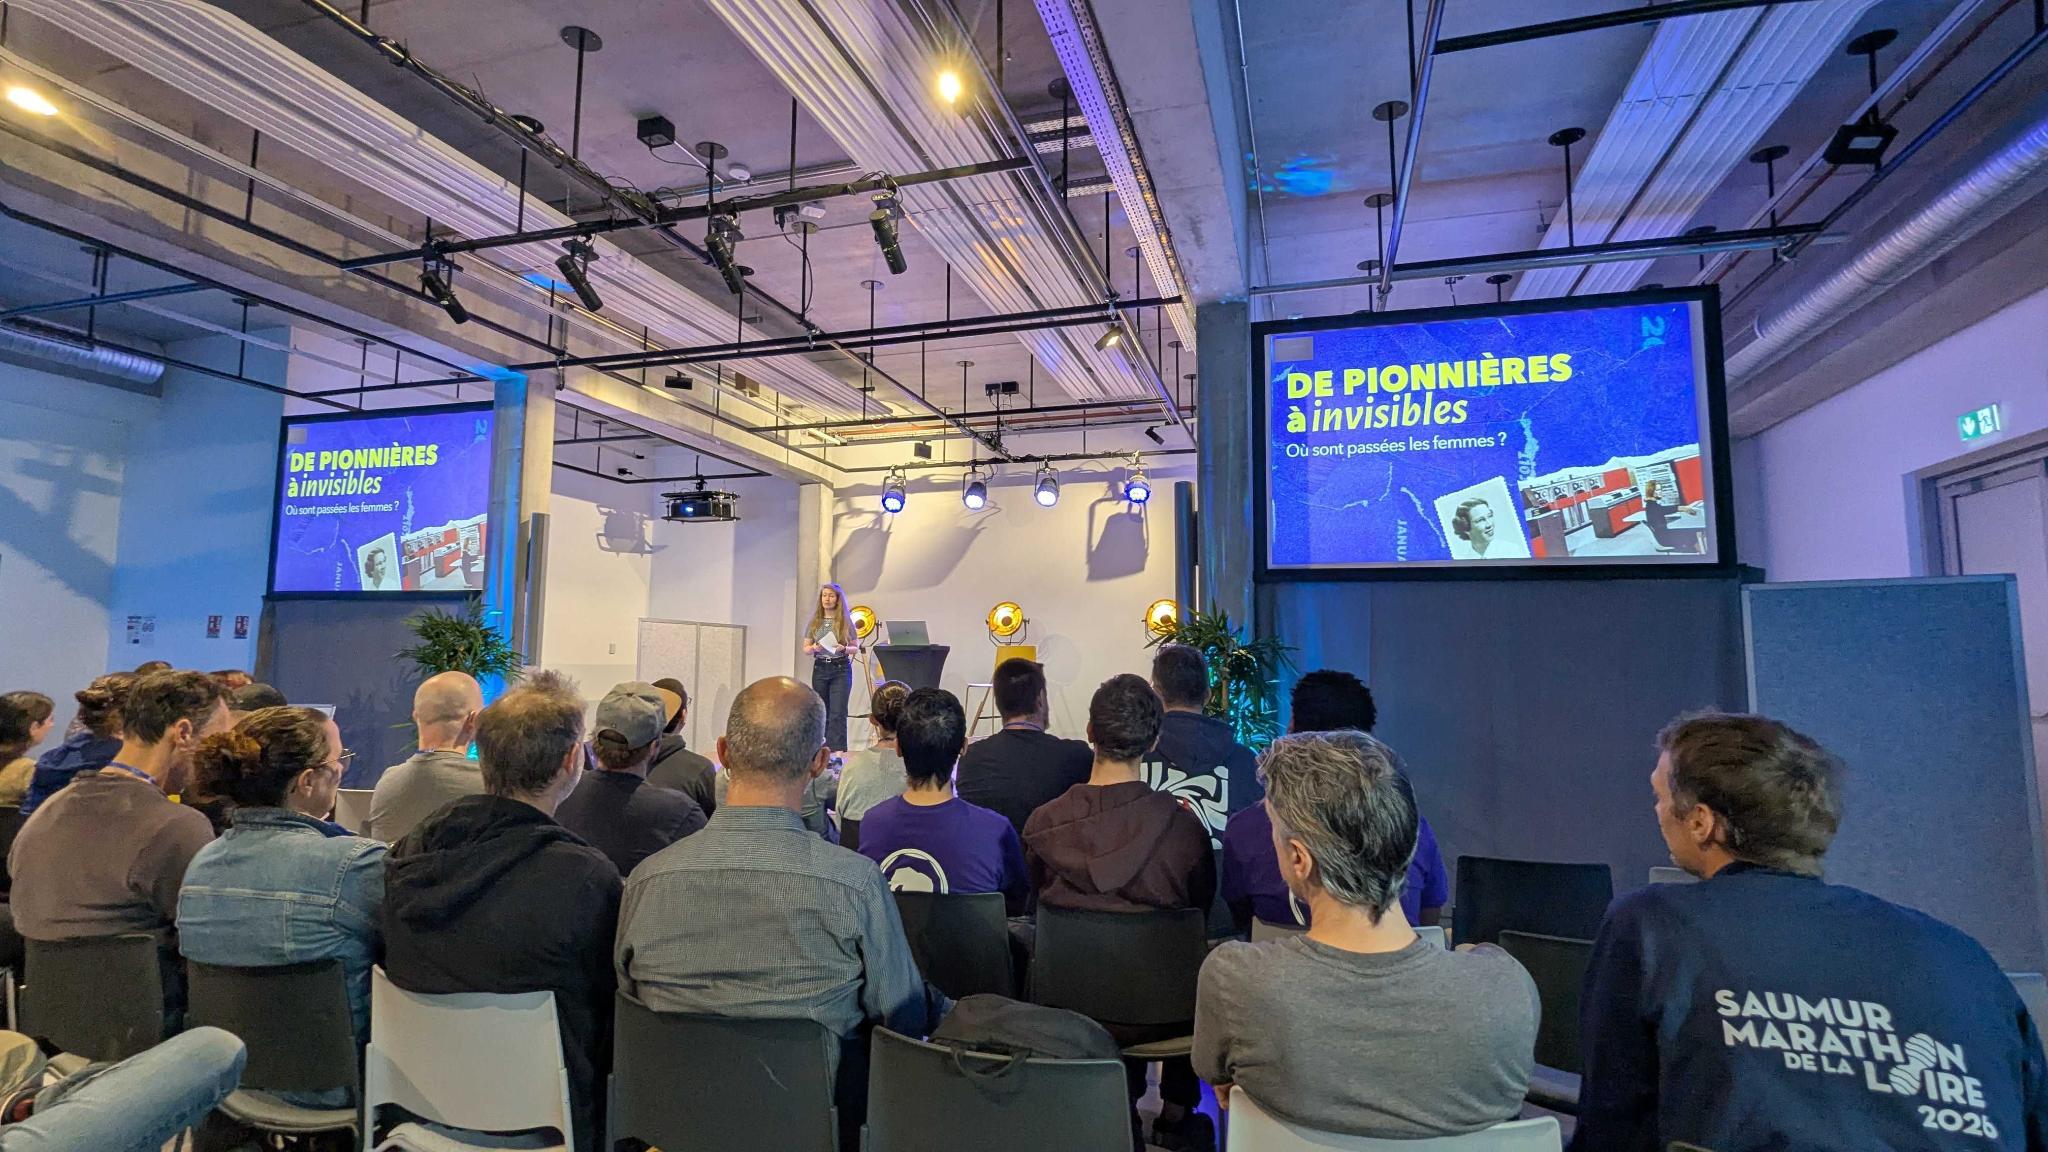
Puis, avec l’apparition de la science de l’informatique à la moitié du XXème siècle, les développeuses jouaient encore un rôle prépondérant dans la programmation car le software était encore considéré comme un travail “secondaire” au détriment de l’Hardware, le “dur”, le “solide”, fait pour les hommes. Chloé explique ce n’est guère qu’à l’ère de la propagation du Personal Computer (PC), et du développement de la culture Geek/Nerd, que l’on a assisté progressivement à la mise au second plan des femmes dans le développement logiciel. Peu à peu, les femmes disparaissent des “success stories” de la tech : C’est l’effet Matilda. Pourtant, elles ont toujours été et sont toujours là !
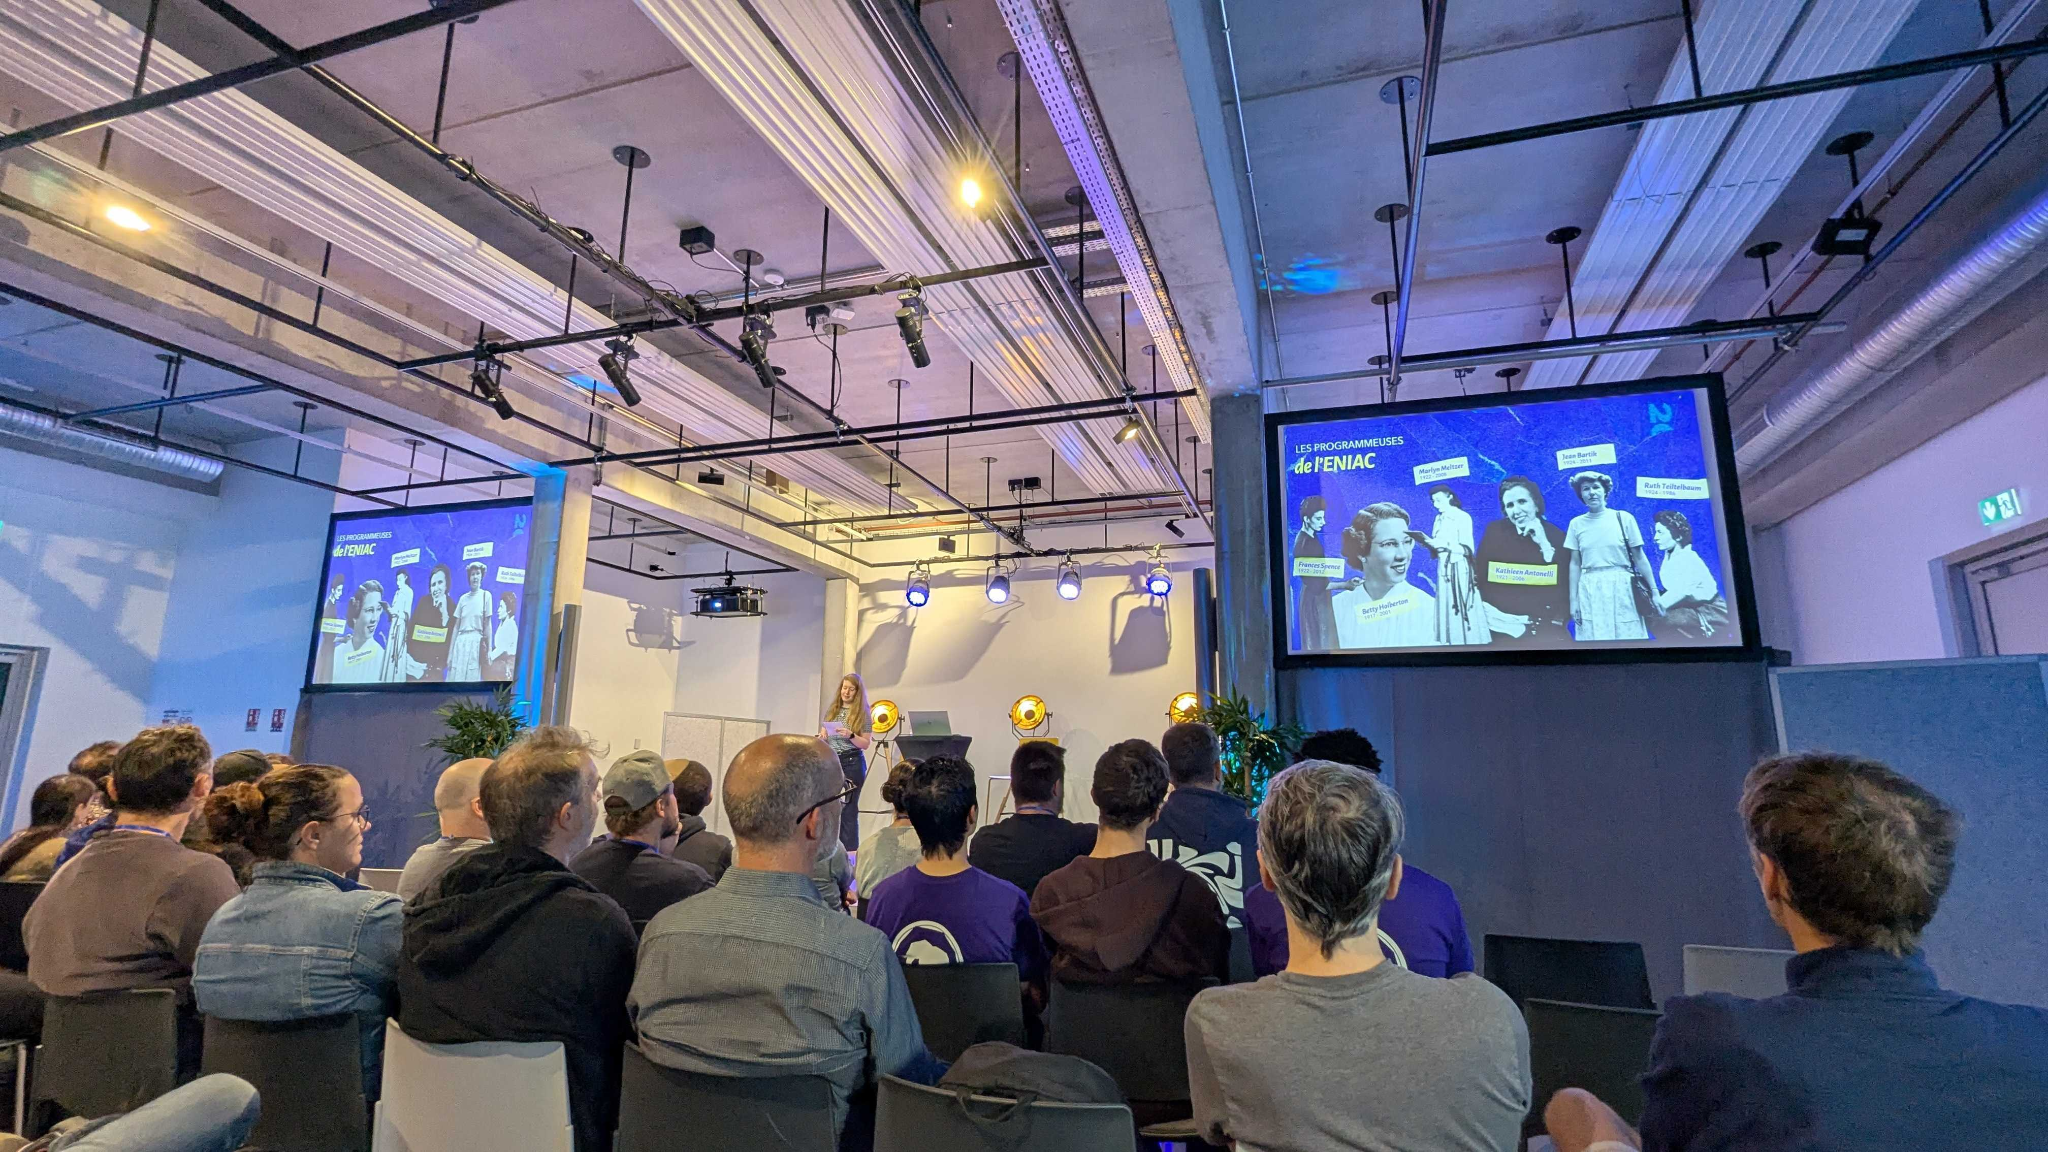
Si des noms comme Ada Lovelace, Margaret Hamilton, Alice Lecoque ne vous parlent pas ou trop peu, ce talk est un bon point d’entrée pour vous pousser à vous documenter encore un peu plus sur la place des femmes dans l’histoire de l’informatique ou même plus globalement dans l’histoire des sciences. Un grand merci à Chloé Masse qui a su rendre ça intéressant, vivant et prenant, donnant très bien le ton de la journée qui s’annonçait !
Pourquoi vos codes reviews passent à côté de l'essentiel ?
par Hafsa Elmaizi - LinkedIn
Dans le cadre de son intervention, Hafsa Elmaizi nous parle de code review, une pratique qui peut vite sembler évidente sur le papier mais qui se révèle beaucoup plus subtile une fois appliquée au quotidien.
Elle nous explique que la review ne se limite pas à détecter des bugs. Elle sert aussi à améliorer le code, à respecter et faire respecter les conventions de l'équipe, à améliorer les process et à partager la connaissance entre ses membres. Le vrai travail du/de la reviewer consiste avant tout à comprendre le code, pas simplement à le valider. Cette lecture s'organise autour de six axes : la fonctionnalité, la lisibilité, la performance, la gestion d'erreurs, la sécurité et les tests.
Pour distinguer ce qui doit vraiment arrêter une PR de ce qui peut attendre, Hafsa Elmaizi propose une grille à quatre niveaux : bloquant, structurant, amélioration et préférence. Un bloquant empêche le merge, comme une faille de sécurité ou un bug qui atteindrait la production. Un structurant impacte la base de code et mérite d'être discuté, par exemple un problème de performance ou une couverture de tests insuffisante. L'amélioration reste une opinion qui vaut le coup d'être partagée, sans urgence. La préférence, elle, est une proposition, elle revient entièrement à l'auteurice du code.
“L'objectif d'une PR n'est pas de tout corriger, mais de corriger ce qui compte”. Il faut se concentrer sur la structure globale et les décisions architecturales avant de s'attarder sur des détails de nommage. Pour formaliser cette hiérarchie, elle nous présente l'outil Conventional Comments, qui permet à chacun de qualifier ses remarques et pousse le/la reviewer à clarifier sa pensée avant de commenter. Il ne faut également pas oublier que des reviews intermédiaires peuvent être très utiles. Elles permettent de discuter des points structurants en amont d'une PR plutôt que de tout reprendre une fois la PR soumise.
En fin de présentation, Hafsa Elmaizi a également abordé l'impact de l'IA sur cette pratique. Le code s'écrivant plus vite, la review devient le nouveau goulot d'étranglement, avec davantage de PR en attente. Certains éléments restent toujours difficiles à déléguer, comme le contexte métier ou l'historique des décisions passées, ce qui pousse les équipes à adopter des approches variées : pas d'IA du tout, une première relecture automatisée avant l'humain, des PR volontairement plus petites, ou un arbitrage selon le niveau de risque.
Le DDD c’est compliqué ? Attendez de mal l’appliquer !
par Nathan Castelein - LinkedIn
Nathan Castelein, est revenu sur sa première mise en place du DDD (Domain-Driven Design) en tant que lead tech. Il avait l’impression d’avoir découvert une recette miracle qui résolvait tous les problèmes que son équipe pouvait rencontrer. Malheureusement, avec le recul, il s’est rendu compte que cette recette n’avait pas eu le succès escompté. Pour nous éviter ces mêmes erreurs, il est revenu sur chaque étape clé de sa mise en place, des problèmes rencontrés et des pistes d’amélioration.
Après avoir découvert le DDD, il a regardé beaucoup de vidéos pour mieux comprendre la méthode. Puis, dans l’espoir de convaincre son équipe, il s’est lancé dans la réalisation d’un PoC entre deux tickets ou sur ses heures perdues le weekend. N’ayant pas la maîtrise de la totalité des concepts du DDD, il s’est restreint à ajouter des entities et séparer le domaine du code plus “technique”. Une fois une grosse fonctionnalité critique du projet migrée, il a proposé une grosse merge request. Cette refactorisation allait permettre d’avoir un code plus propre et plus maintenable. L’équipe a donc accepté la merge request. Mais deux ans plus tard, “faire le code en mode DDD” est presque devenu une blague et la migration du reste du projet n’a pas eu lieu.
Après nous avoir montré que cela n’avait pas porté ses fruits, Nathan Castelein nous a expliqué que le DDD n’est pas une architecture logicielle (contrairement à ce qu’il croyait comprendre à ses débuts).
On distingue le DDD stratégique qui permet de définir les Bounded Contexts, les sous-domaines, le langage commun. Il définit le quoi et le où du projet. C’est la partie du DDD jugée essentielle pour une transition réussie. Ensuite vient le DDD tactique qui permet de modéliser les entities, les value objects, les aggregates, les repositories. Il répond au comment.
Comme tout bon crafter, il a procédé à une autocritique pour identifier les étapes qui ont participé à l’échec de la mise en place du DDD dans son projet :
- Se lancer dans un POC seul, sans en informer l'équipe
- Laisser le code legacy et le code DDD cohabiter, même deux ans après
- Ne pas prendre en compte la résistance au changement et la perte de vitesse le temps que l’équipe maîtrise la démarche
- Ne pas interroger la pertinence du projet (plutôt passe-plat, peu de logique métier) pour une approche DDD
S’il devait recommencer, voici les pistes d’amélioration qu’il a identifiées :
- Démarrer par le stratégique : faire des event stormings, des context mappings et des example mappings
- Trouver un point de départ concret et progressif : commencer petit, par exemple avec les value objects, avant de s'attaquer à un seul concept à la fois
- Apprendre ensemble : impliquer l’équipe entière dès le début via des book clubs, des cercles tournants ou une cartographie des savoirs
- Mieux comprendre plutôt que consommer le savoir comme on consommerait une série en streaming : prendre des notes, se rapprocher de la communauté
- Coder ensemble plutôt que chacun dans son coin : organiser des katas, faire des POC visibles et partagés
- Adopter une meilleure attitude : une solution n'est bonne que si elle est comprise et validée par l'équipe (voir l’egoless crafting)
J’ai trouvé cette conférence très accessible et intéressante même quand on ne connaît pas le DDD. J’ai pu repartir avec des clés concrètes pour essayer de mieux le mettre en place dans des projets futurs.
Object Calisthenics : simplifier le code pour retrouver le métier
par Jacqueline Rwanyindo - LinkedIn
Lors de cette conférence au format quickie, Jacqueline Rwanyindo compare plusieurs principes de développement à la callisthénie.
Elle introduit la complexité sous trois axes : essentielle, obligatoire et accidentelle. La complexité essentielle est celle qui découle des règles métiers et délivre une réelle valeur ajoutée. La complexité obligatoire naît des choix architecturaux et des solutions techniques mises en place. Pour finir, la complexité accidentelle est celle à éviter et finit par prendre la forme de dette technique.
Sa présentation s’appuie sur le livre Object Calisthenics de Jeff Bay. Dans ce livre, Jeff Bay introduit un ensemble de neuf contraintes de programmation dans le but d’améliorer la qualité du code dans un environnement de programmation orienté objet.
Jacqueline Rwanyindo développe ces neufs principes qui permettent de lutter contre la complexité accidentelle. Elle le fait en les comparants à la discipline de la callisthénie. Cette approche originale couplée à d’excellents exemples en font une présentation agréable et détaillée à suivre.
Qui contrôle l'IA contrôle le récit
par Aurélien MASSIOT - Linkedin
Cette conférence présentée par Aurélien MASSIOT interroge sur la place de l'intelligence artificielle générative dans la fabrique du discours collectif et donc dans les rapports de pouvoir.
L'idée de départ : celui qui contrôle le récit contrôle, dans une certaine mesure, la société. Ce n'est pas propre à l'IA. La conférence a retracé cette dynamique à travers plusieurs ruptures technologiques et sociales dans l’histoire :
- L'oral, premier support du récit, transmis et déformé au fil des générations.
- L'écriture, qui fixe le récit dans le temps et en fait un instrument de pouvoir : ce qui est écrit fait autorité.
- La religion, qui s'appuie sur le récit pour établir des normes morales partagées.
- L'imprimerie, qui démocratise l'accès au récit, mais ouvre aussi la voie à la circulation de vrais et de faux récits à grande échelle.
- Les médias de masse, qui standardisent le récit à l'échelle d'une société.
- Les réseaux sociaux, qui introduisent un récit algorithmique : ce n'est plus seulement le contenu qui compte, mais sa priorisation par des algorithmes de recommandation.
- L'IA générative, dernière étape en date, qui permet de produire du récit de façon automatisée et à très grande échelle.
Chaque rupture technologique redistribue donc qui peut produire du récit, à quelle échelle, et selon quelles règles. L'IA générative s'inscrit dans cette continuité, avec un changement d'échelle inédit.
Les problèmes posés par l'IA générative sont nombreux. Deux points de vigilance ressortent particulièrement :
1. Une production de faux contenus en hausse. La capacité à générer du texte, de l'image ou de la vidéo de façon crédible et massive facilite la diffusion de contenus trompeurs.
2. Une concentration du contrôle entre quelques mains. Les modèles d'IA générative les plus utilisés sont aujourd'hui développés et opérés par un nombre restreint d'acteurs, essentiellement américains et chinois. Le récit produit à grande échelle dépend donc des choix (techniques, économiques, réglementaires) d'un petit nombre d'organisations.
Un point clé de la conférence : un modèle de langage ne prédit pas le vrai, il prédit le vraisemblable. Il génère la suite de mots statistiquement la plus probable au regard de ses données d'entraînement, pas la suite factuellement exacte. Les réponses apportées par l’IA se construisent aussi via des choix politiques (au sens large), qui interviennent dans la sélection des données d'entraînement, les règles de modération, ou les orientations données aux modèles.
Certaines pistes ont été évoquées pour limiter ces dérives et ces biais :
- Plus de transparence sur la construction des modèles (données d'entraînement, méthodes de fine-tuning, critères de modération)
- Sensibiliser les gens pour rendre le fonctionnement de l'IA accessible au plus grand nombre et sortir des postures d'émerveillement ou de rejet.
Au final, cette conférence rappelle à juste titre que l’utilisation des outils IA n’est pas anodine et doit se faire en connaissance de cause, afin d'avoir toujours un regard critique sur les réponses obtenues, peu importe le modèle choisi.
Les plaques tectoniques du legacy : anticiper les séismes architecturaux
par Christophe Breheret-Girardin - LinkedIn
Un séisme est la libération brutale d'une tension accumulée pendant des années entre des plaques tectoniques. C'est la métaphore qu'a choisie Christophe Breheret-Girardin pour aborder le sujet du legacy. Que ça soit les frictions qui rallongent le temps de dev, le code incompréhensible, ou les bugs de prod à répétition, ce ne sont que des conséquences de tensions techniques accumulées, telle qu'une dette technique grandissante ou des périmètres fonctionnels dérivants.
4 conditions sont nécessaires pour rendre un refactoring possible : Un comportement suffisamment stable pour itérer, une couverture de test (existante ou à réaliser), une équipe possédant les compétences de refactoring, et un environnement de développement permettant des itérations rapides et sûres. Pour la réalisation de tests, une technique classique consiste à extraire le comportement à isoler dans une méthode protégée, puis à la surcharger dans une sous-classe de test pour l'exécuter hors de son contexte d'origine. Christophe évoque également d'autres outils de refactoring du même esprit : wrap class / wrap method, sprout class / sprout method, extraction d'interface, ou encore scratch refactoring.
Quatre régimes tectoniques différents
Le sujet principal de la conférence associe chacun des quatre types de mouvements tectoniques à une stratégie de traitement du legacy, avec ses bénéfices et ses risques.
Le régime coulissant : 2 plaques glissent l'une contre l'autre sans se chevaucher. Il s'agit d'améliorer la qualité du code existant progressivement et chirurgicalement, sans nécessairement toucher à l'architecture globale. La stratégie permet de garder la main sur l'investissement, de livrer régulièrement et de maintenir la continuité de service, à condition d'avoir une base de code suffisamment saine et une bonne couverture de tests. Elle implique en revanche un ralentissement des développements, des résultats peu visibles côté métier, et de potentielles frictions entre refactoring et développement de nouvelles fonctionnalités.
Le régime compressif avec subduction : une plaque s'enfonce sous l'autre, et un nouveau relief se forme à sa place. Ici, une nouvelle application est développée en parallèle du legacy, et mise à disposition intégralement lorsqu'elle est prête. L'option permet la remise à zéro technique la plus nette ainsi qu'un réalignement métier-technique propre, mais elle suppose une application de taille raisonnable, et d'assumer un arrêt de service au moment de la bascule. Une « refonte big bang » est à réserver à certains contextes précis tels qu'un coût de maintenance trop élevé ou une obligation légale. Les risques encourus sont un ROI tardif, un budget conséquent, et un risque d'échec concentré sur le jour de la bascule.
Le régime compressif avec compression : le terrain se plisse et se réorganise par blocs successifs. On va chercher à isoler les modules pour les refondre successivement, afin de remplacer le legacy petit à petit. Il est plus facile de maîtriser la progression de la migration de cette manière, mais il faut pouvoir découper l'existant en modules indépendants. En pratique, la cohabitation de modules legacy et refondus peut générer une surcharge d'infrastructure et une tentation d'utiliser des solutions de contournement.
Le régime extensif : les plaques s'écartent et laissent place à un nouvel espace. On modélise le flux d'évènements d'un parcours utilisateur (par exemple en faisant de l'event-storming) pour regrouper des contextes métiers aux périmètres bien définis. On peut ensuite migrer par parcours utilisateur plutôt que par module. L'approche se concentre sur le métier, et permet une transition en douceur, mais il faut s'assurer d'un alignement solide entre métier et technique. Il faut également noter que l'expérience utilisateur risque d'être hétérogène tant que tous les parcours n'ont pas basculé.
Savoir où concentrer sa refonte : le Core-Domain chart
Pour nous aider à décider où porter l'effort de refonte, Christophe nous propose d'utiliser le Core-Domain chart, un outil issu du Domain-Driven Design. Il s'agit de croiser la complexité du modèle métier et sa différenciation avec la concurrence, pour répartir les fonctionnalités dans 3 zones. La zone generic, où la complexité ne justifie pas un développement sur mesure et où une solution sur étagère suffit. La zone supporting, une zone de fonctionnalités peu différenciantes et peu complexes, donc à garder simples. Et le core, qui est composé des fonctionnalités complexes et différenciantes, sur lesquelles on doit concentrer l'effort de refonte.
Agents, skills, hooks : un live coding pour les gouverner tous, sans sacrifier la qualité ! ❤️
par Ambre Person - LinkedIn
Ambre Person a proposé un format un peu différent des autres conférences lors de cette 2e édition de Nantes Craft. Il est parti du constat qu’on parlait beaucoup d’IA, mais souvent d’un axe théorique. Il a voulu nous montrer la mise en pratique de ces connaissances. Il a relevé le défi de nous faire le live coding d’une application à l’aide de l’IA générative en seulement 1h. Son objectif : créer de zéro une application avec le bon harnais. Le harnais est l’ensemble des instructions qui cadrent l’IA. Il permet d’augmenter la probabilité que l’IA produira quelque chose selon nos bonnes pratiques et nos règles. Il nous a invité à consulter le manifeste pour un développement raisonnable avec l’IA.
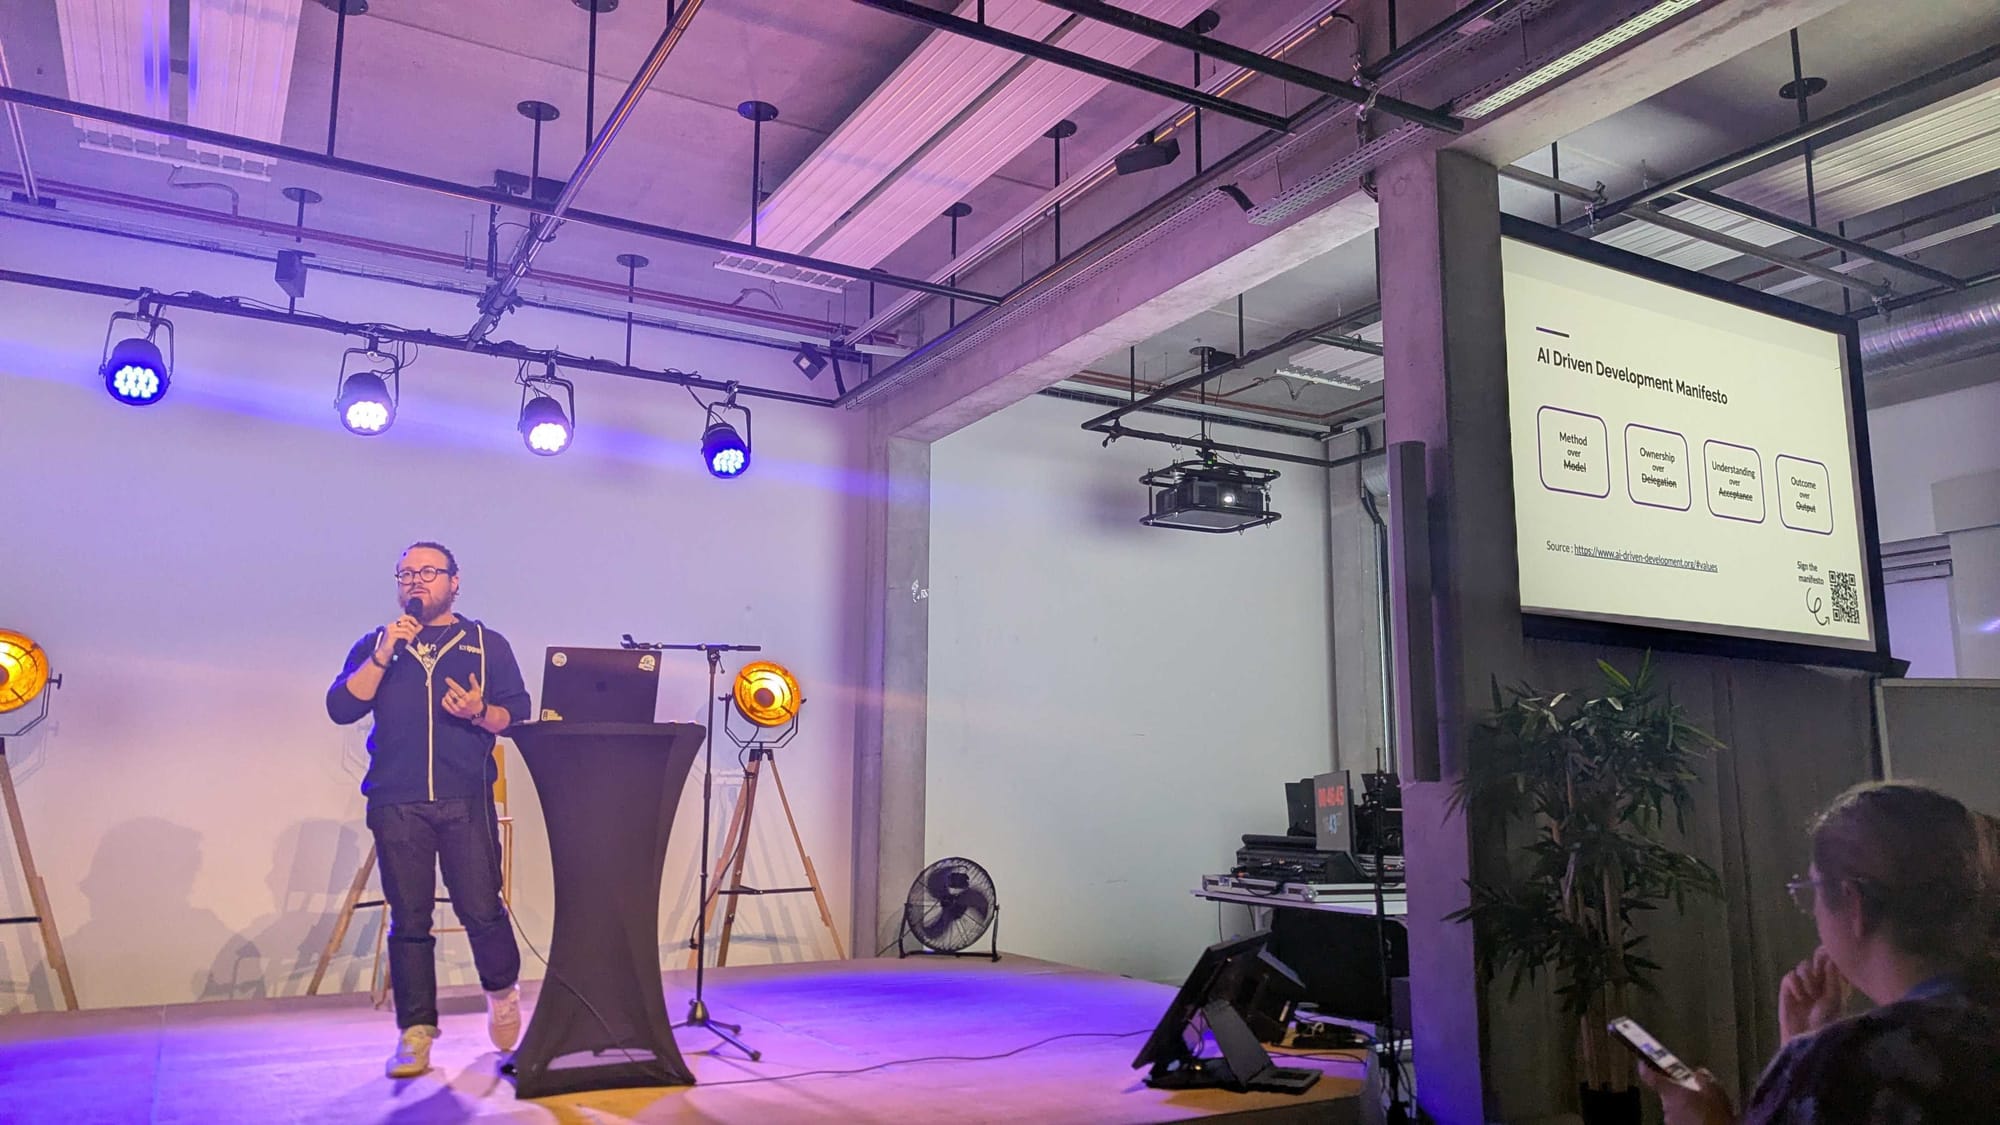
Pour cette démonstration, il a utilisé Claude avec le modèle Sonnet. Il a commencé par co-écrire avec Claude les skills nécessaires à la définition du harnais. Puis il les a utilisés pour créer l’application selon ses standards. Nous avons vu également comment créer et utiliser des agents pour paralléliser les tâches.
Pour implémenter l’application, il a fallu commencer par définir et rédiger des spécifications. Une fois validées, il fallait concevoir les tâches à partir de ces spécifications. Une fois ces tâches validées, l’IA pouvait implémenter le code le plus correctement possible.
Pour chaque prompt, il nous a expliqué le but et les bonnes pratiques. Il nous a aussi mis en garde qu’il fallait à chaque étape bien vérifier et valider ce que produisait l’IA. l’importance de cette validation a d’ailleurs été démontrée grâce à ce live coding. En effet, pour ne pas perdre de temps, Ambre Person validait systématiquement ce que l’IA proposait, sans la corriger. Et à la fin de l’implémentation, il y avait des bugs et une phase supplémentaire d’ajustement de la conception aurait été nécéssaire.
Le format était assez interactif car il a utilisé les temps morts pendant lesquels l’IA produisait le code pour répondre aux différentes questions du public. Cette conférence a aussi permis de voir concrètement l’interface et le résultat de principes dont on entend beaucoup parler en ce moment.
Journée de non-conférence
Les conférences c’est très enrichissant mais parfois le sujet abordé ne nous correspond pas, le format ne nous permet pas de bien comprendre, ou l’axe choisi ne permet pas répondre aux questions qu’on se posait. Malgré la possibilité de poser des questions en fin de session ou sur l'événement, ça ne permet pas toujours de vraiment creuser le sujet en profondeur.
Qu’est-ce qu’une non-conférence ? Il s’agit d’un format permettant de rendre aux participant·es les clés des sujets abordés et de leur format. Chaque participant·e peut proposer un ou plusieurs sujets sans obligation, l’objectif étant d’avoir des sujets à discuter à chaque créneau horaire disponible.Les sujets proposés ne sont pas forcément des sujets où la personne qui propose est experte ou souhaite animer la discussion, il est tout à fait possible de demander un échange sur un sujet que l’on ne maîtrise pas dans l’objectif de monter en compétences.
À Nantes Craft, les participant·es ont été très inspirés et + de 20 sujets ont été proposés sur des thématiques très variées (IA, Architecture, Social, Techno, Kata…), à chaque demi journée le planning est discuté pour s’assurer qu’il correspond aux attentes des participant·es.
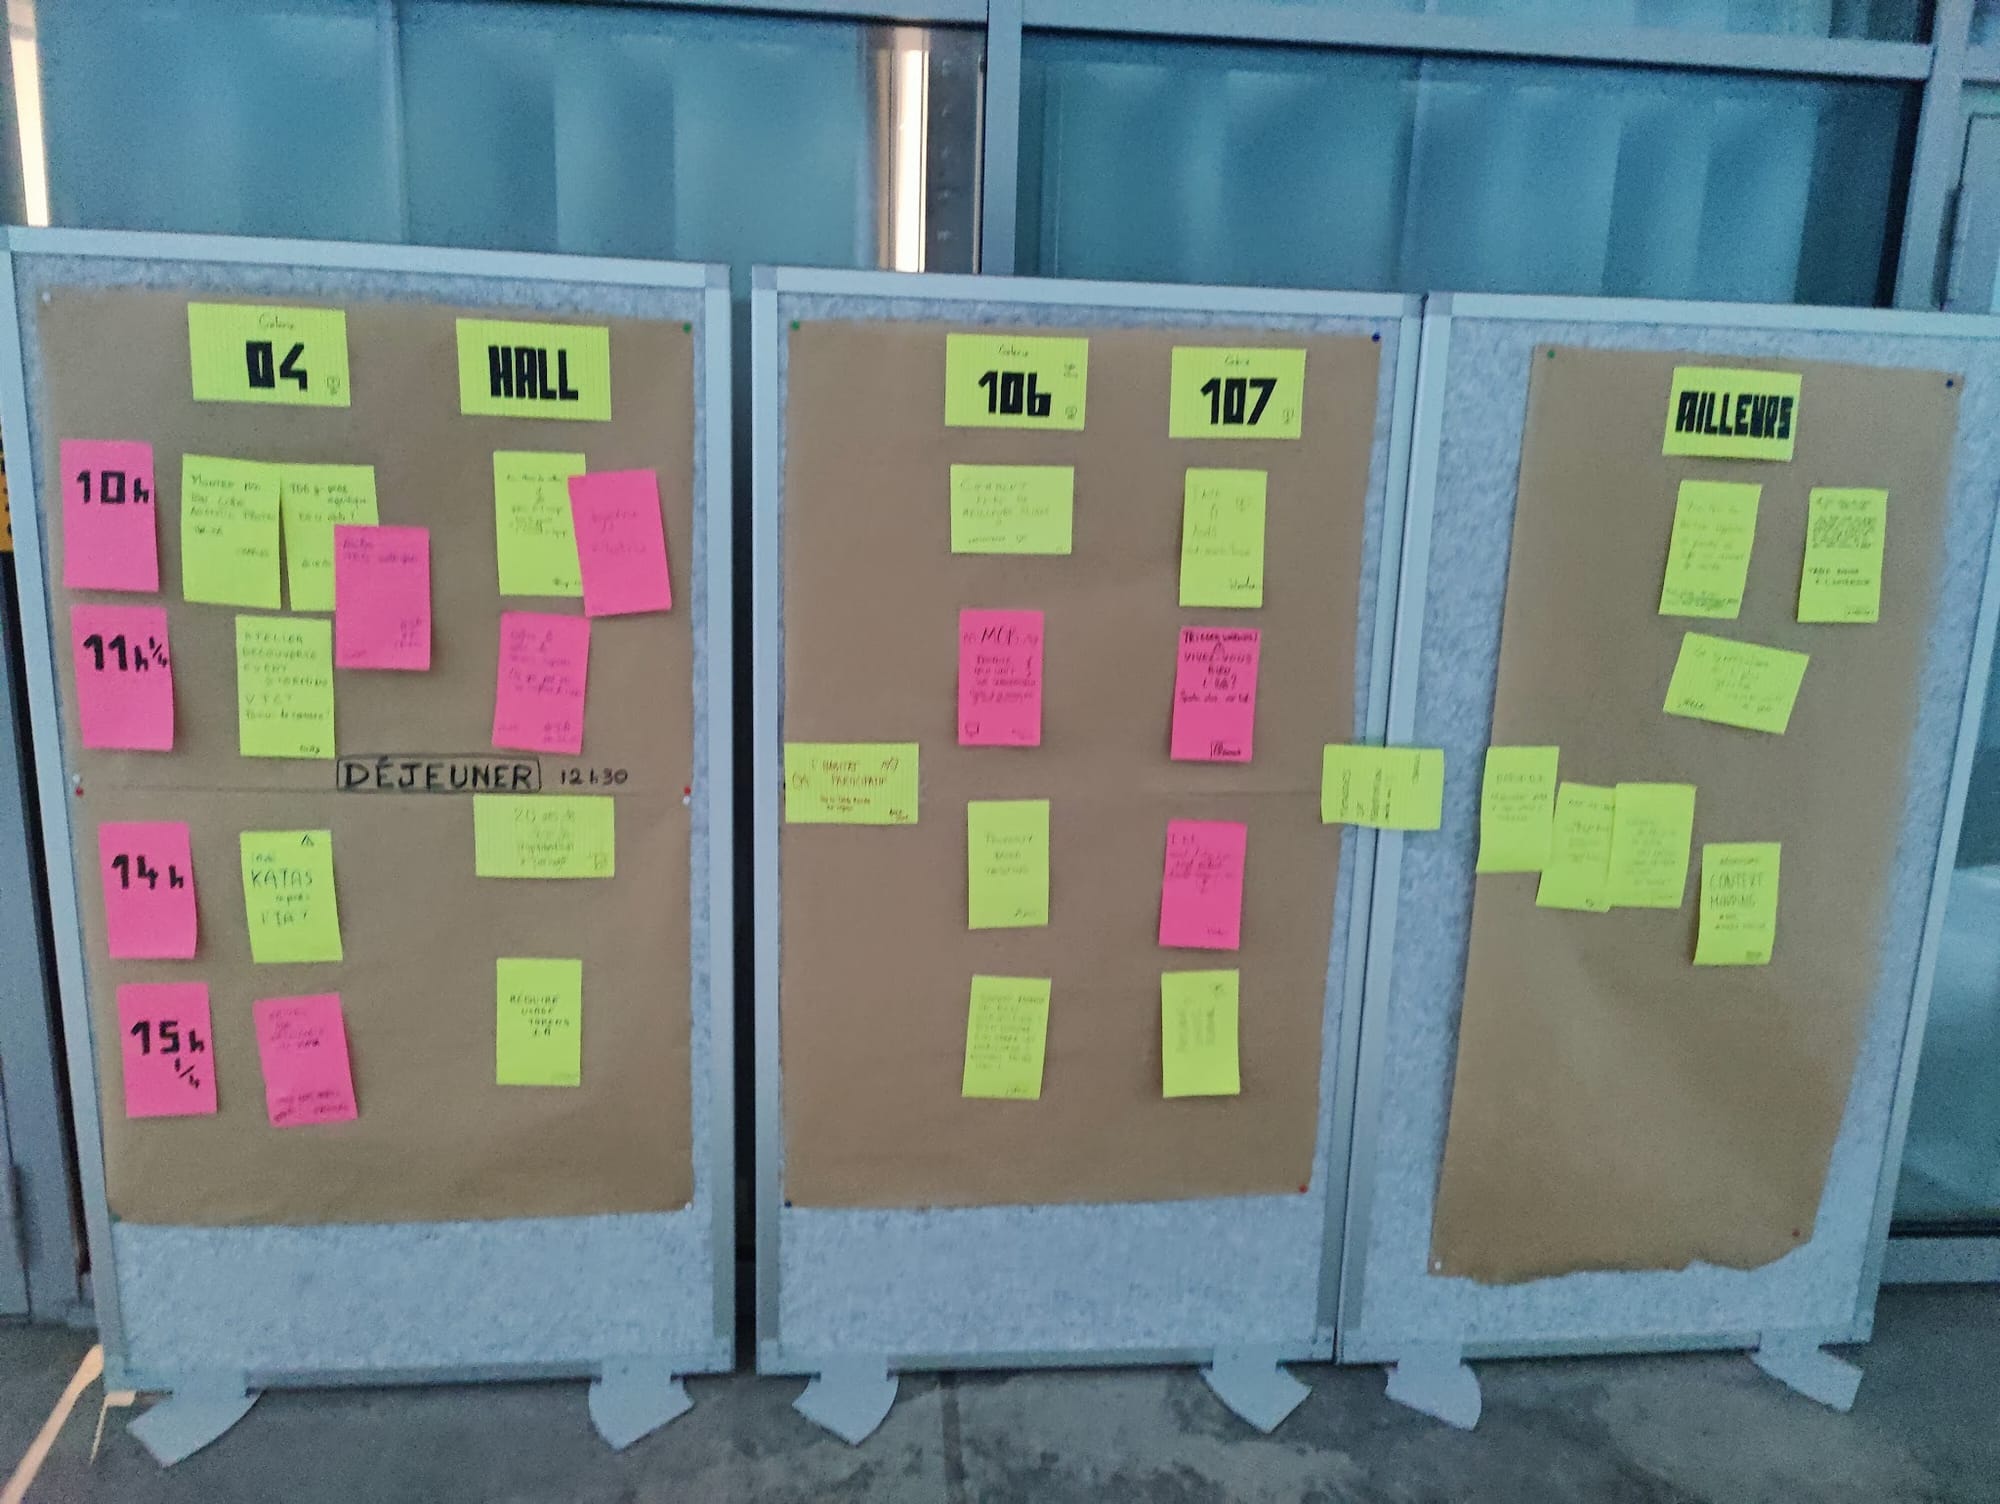
À chaque créneau horaire, on choisit la discussion qui nous intéresse le + pour aller simplement écouter ou participer activement à l’échange. Il est également possible de passer de sujet en sujet pour tirer partie de plusieurs discussions.
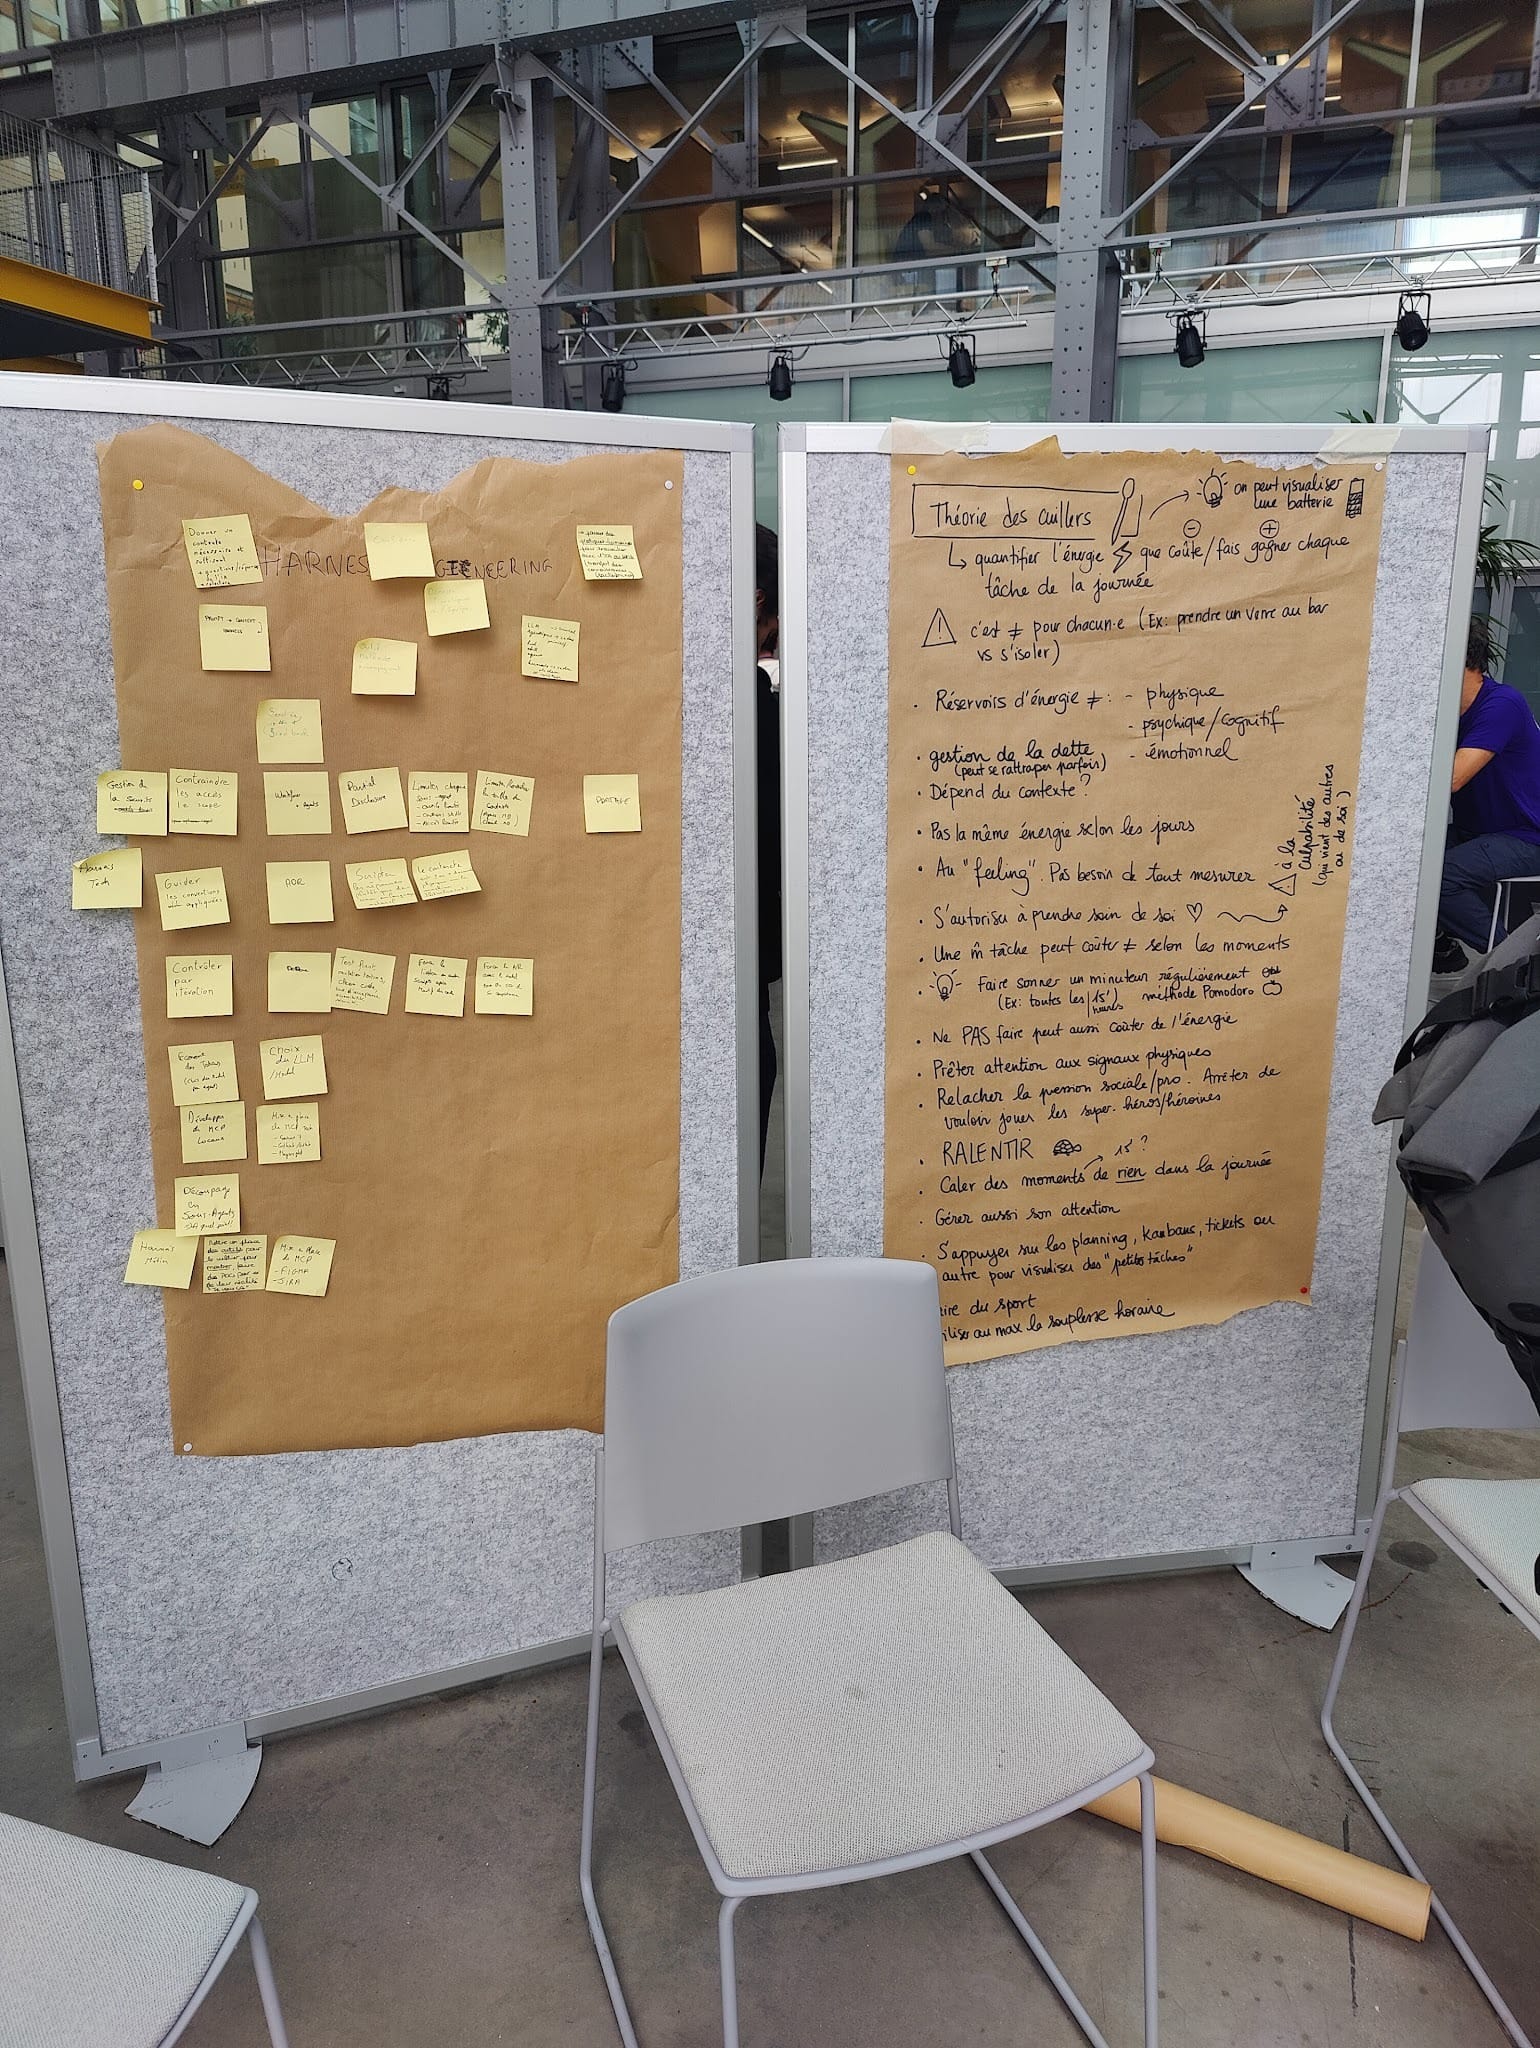
Cette journée a permis de remettre l’humain et les interactions au centre, de partager ses expériences, questions, doutes… avec ses pairs dans un environnement safe propice aux échanges. Une vraie émulsion se dégage de ces événements et les discussions ne s’arrêtent vraiment jamais et continuent pendant les pauses et les repas. Ce n’est pas toujours facile dans un événement de conférence tech traditionnel de démarrer un échange avec des personnes que l’on ne connaît pas déjà, là tout était fluide et favorise le partage qui nous est cher dans la communauté Craft, sans jugement de valeur ni de prise de hauteur vis à vis de l’expertise.
Si vous avez l’occasion de participer à une journée de non-conférence, foncez !