

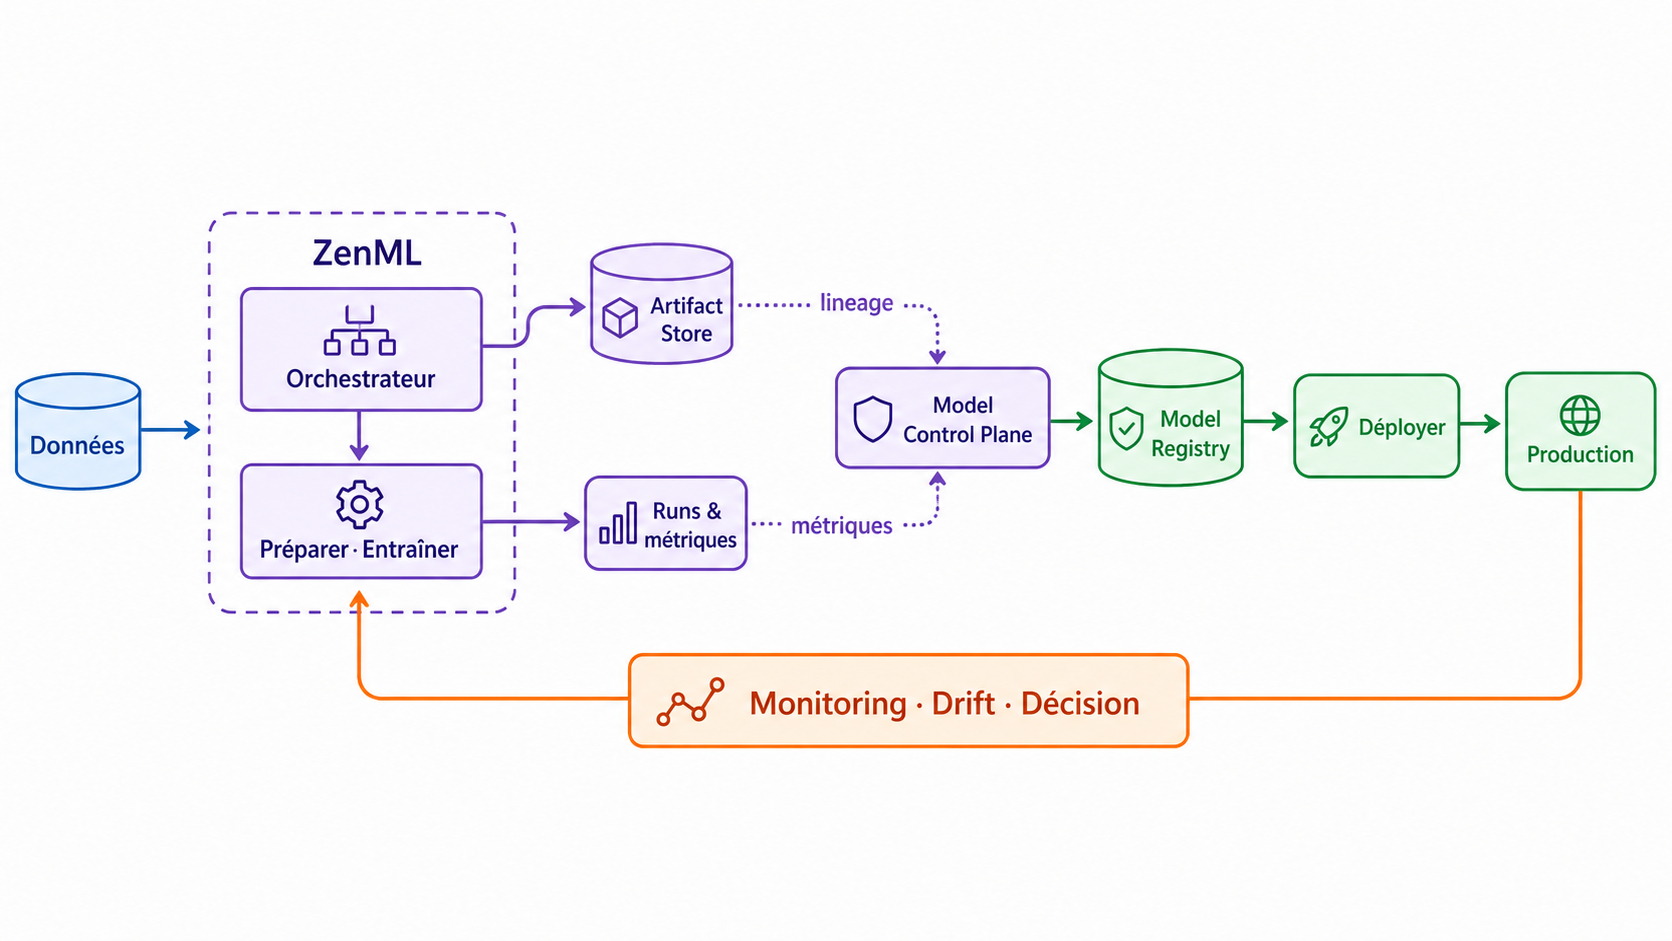
Un pipeline d’entraînement planifié chaque semaine, quelques tâches qui s’enchaînent et un modèle sauvegardé dans un bucket : à première vue, le système semble industrialisé.
Puis, un lundi matin, les prédictions de churn (le risque qu’un client cesse d’utiliser un produit ou un service) deviennent incohérentes. Le pipeline a bien tourné. Aucun job n’est en erreur. Pourtant, l’équipe ne peut pas répondre rapidement à quelques questions simples : quel jeu de données a entraîné la version actuellement déployée ? Quels paramètres ont été utilisés ? La qualité du modèle s’est-elle dégradée, ou bien les données de production ont-elles changé ?
C’est ici que se situe la frontière entre orchestration et MLOps. Un orchestrateur est indispensable pour exécuter un workflow de manière fiable. Mais il ne suffit pas, à lui seul, à rendre un système de machine learning reproductible, déployable, gouverné et observable.
Ce qu’un orchestrateur fait très bien
Prenons le cas d’un modèle de prédiction de churn. Chaque semaine, un pipeline doit extraire les données clients, préparer les variables nécessaires au modèle, entraîner plusieurs candidats, évaluer leur performance et publier le meilleur modèle.
Un orchestrateur généraliste comme Airflow, ou une plateforme de pipelines ML comme Kubeflow Pipelines, répond très bien au besoin de coordonner un workflow. Kubeflow Pipelines couvre davantage de besoins orientés ML (composants conteneurisés, artefacts, runs et expérimentations) là où Airflow reste volontairement généraliste.
Le point n’est donc pas de les considérer comme équivalents, ni de minimiser leurs capacités. Même une plateforme de pipelines ML ne garantit pas, à elle seule, la traçabilité complète entre les données, le modèle déployé, les signaux de production et la décision de réentraîner.
Un orchestrateur, c’est déjà beaucoup. Sans orchestration, les entraînements reposent rapidement sur des scripts lancés manuellement, des notebooks python, des étapes implicites et des traitements difficiles à rejouer.
Dans la plupart des orchestrateurs, un workflow de Machine Learning est représenté sous la forme d’un DAG (Directed Acyclic Graph) : un graphe de tâches reliées par des dépendances, exécutées dans un ordre donné, sans boucle de retour.
Mais l’orchestrateur répond avant tout à trois questions : quand exécuter le pipeline ? Dans quel ordre lancer les tâches ? Que faire si une tâche échoue ?
Ces questions sont nécessaires à l’automatisation. Elles ne couvrent cependant pas la totalité du cycle de vie d’un modèle. Le périmètre d’un orchestrateur reste donc centré sur l’exécution du pipeline.
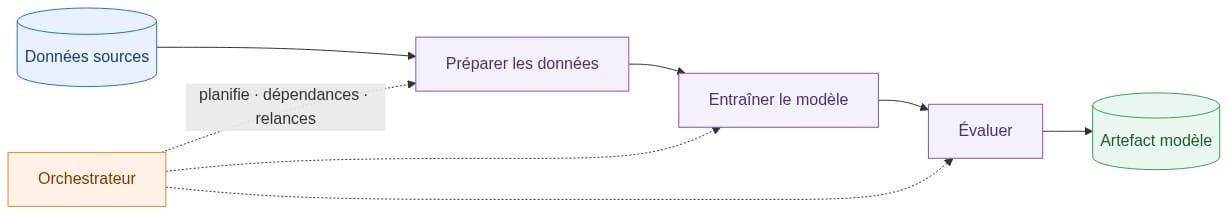
Figure 1 — Un orchestrateur organise l’exécution d’un pipeline, sans couvrir la boucle de production.
Le problème : un modèle ne se résume pas à un job réussi
Pour une application classique, un artefact de livraison est souvent directement lié au code source et à une version de l’application. En machine learning, la réalité est plus complexe.
Le comportement d’un modèle dépend à la fois du code et de ses dépendances, des données utilisées pour l’entraînement, des transformations appliquées, des paramètres d’entraînement, de l’environnement d’exécution et des conditions rencontrées en production.
Un pipeline peut donc réussir techniquement tout en produisant un modèle inadapté. Un changement dans une source de données peut dégrader les prédictions sans générer la moindre erreur. À l’inverse, un excellent score hors ligne ne garantit pas que le modèle soit pertinent une fois confronté aux données réelles.
Le MLOps consiste précisément à organiser cette chaîne de responsabilité : de la donnée jusqu’au suivi de la qualité en production. Il couvre l’automatisation et le monitoring, mais aussi l’intégration, les tests, la livraison, le déploiement et la gestion de l’infrastructure.
La rupture entre entraînement et production
Un modèle peut être performant lors de son évaluation hors ligne tout en produisant des prédictions moins fiables en production. Les données réelles évoluent, certaines transformations peuvent différer entre l’entraînement et la mise en service, et les contraintes opérationnelles ne sont pas toujours représentées dans les jeux de test.
La reproductibilité ne consiste donc pas seulement à pouvoir relancer un entraînement. Elle implique de conserver le lien entre le code, les données, les transformations, l’environnement et le modèle déployé. L’évaluation temporelle, le partage des étapes de préparation et le versionnement des artefacts réduisent ce risque, sans l’éliminer totalement.
Les responsabilités qu’un orchestrateur ne couvre pas seul
Reproduire et expliquer une décision
Lorsqu’un modèle est promu en production, il doit être possible de retrouver les éléments qui ont conduit à cette décision : version du code, dataset, paramètres, métriques et artefacts produits.
Sans ce lien, investiguer un incident devient coûteux. On se retrouve à parcourir des logs, à chercher un fichier de modèle parmi plusieurs emplacements et à reconstituer les conditions d’un entraînement a posteriori.
La traçabilité ne sert pas uniquement à gérer les incidents. Elle permet également de comparer les expérimentations, d’auditer une décision et de rejouer un entraînement à l’identique.
Évaluer avant de déployer
Un pipeline peut calculer une métrique de performance. Cela ne signifie pas qu’il applique une règle de promotion.
Avant de déployer un modèle de churn, une équipe peut vouloir vérifier que le score est supérieur à celui du modèle actuellement en production, que l’écart de performance entre segments de population reste acceptable, que les variables critiques sont présentes et dans des plages cohérentes, et que le temps de réponse respecte les contraintes de l’application.
Ces critères doivent être explicites, automatisables et rattachés à une version précise du modèle. Sans cela, le déploiement reste une décision manuelle difficile à justifier et à rejouer.
Déployer un modèle ne signifie pas lancer un entraînement
Le modèle sélectionné doit ensuite être enregistré, versionné, validé et déployé vers son environnement cible. Il faut aussi prévoir le retour arrière, la mise à jour de l’API de prédiction et les stratégies de déploiement progressif lorsque le niveau de risque le justifie.
L’orchestrateur peut déclencher ces opérations. Il ne fournit pas nécessairement, à lui seul, le contrat entre le modèle entraîné et le modèle réellement servi.
Un model registry, une chaîne CI/CD et une plateforme de serving jouent ici des rôles complémentaires. Ils permettent de séparer l’entraînement, la décision de promotion et l’exposition du modèle aux utilisateurs.
Surveiller la bonne métrique
Un monitoring technique indique que l’API est disponible, que sa latence est maîtrisée et qu’elle ne produit pas trop d’erreurs. C’est indispensable, mais ce n’est pas suffisant. Dans notre exemple, le modèle peut répondre en quelques millisecondes tout en perdant progressivement sa capacité à prédire le churn. Les comportements clients changent, de nouvelles offres apparaissent ou certaines variables ne sont plus calculées de la même manière.
Il faut donc surveiller les données reçues en production pour détecter une dérive de données (data drift), suivre la distribution des prédictions pour repérer une dérive de prédictions (prediction drift) et, lorsque les labels sont disponibles, mesurer la performance réelle du modèle. Le monitoring fournit des signaux de décision : selon le diagnostic, l’équipe peut réentraîner, corriger ou retirer le modèle.
Du signal de dérive à la décision de réentraîner
Le monitoring nécessite une brique dédiée : il produit les signaux dont une plateforme MLOps a besoin pour décider. La valeur d’une plateforme MLOps apparaît lorsque ces signaux de potentielles dérives des données sont reliés à une version précise du modèle. Ils peuvent déclencher une réévaluation, comparer le modèle en production à un candidat et apporter les éléments nécessaires à une décision de promotion. Le réentraînement devient alors une action contrôlée et justifiable, plutôt qu’une réaction automatique à une alerte.
Le piège du pipeline qui fait tout
Une erreur fréquente consiste à ajouter progressivement toutes ces préoccupations dans le graphe d’orchestration : du code de tracking dans chaque tâche, des conventions implicites pour nommer les modèles, la copie d’artefacts entre plusieurs stockages, une logique de promotion liée à l’environnement, des appels directs à l’outil de serving et des scripts de monitoring séparés.
Cette approche fonctionne souvent au début. Elle devient ensuite fragile : les conventions sont difficiles à partager, les composants sont couplés et l’évolution du pipeline nécessite de connaître les détails de tous les outils sous-jacents.
Le problème n’est donc pas l’orchestrateur : coordonner l’exécution d’un workflow est précisément son rôle. La difficulté apparaît lorsqu’on lui fait porter, à l’aide de scripts et de conventions maison, les responsabilités de registre de modèles, de gestion d’artefacts, de déploiement et d’observabilité.
Une plateforme MLOps : assembler les bonnes responsabilités
Une plateforme MLOps n’est pas forcément un produit unique. C’est un ensemble cohérent de briques qui rend le cycle de vie du modèle explicite.
Chaque composant porte une responsabilité claire : l’orchestrateur exécute et planifie les workflows ; le stockage d’artefacts conserve les jeux de données, modèles et rapports ; le tracking d’expériences compare les paramètres, métriques et résultats ; le registry organise les versions de modèles et leur promotion ; la chaîne CI/CD contrôle les changements de code, d’infrastructure et de configuration ; le serving expose les prédictions ; le monitoring suit la santé technique, la dérive des données et la qualité métier.
Cette boucle devient continue lorsque les signaux de production alimentent une décision explicite.
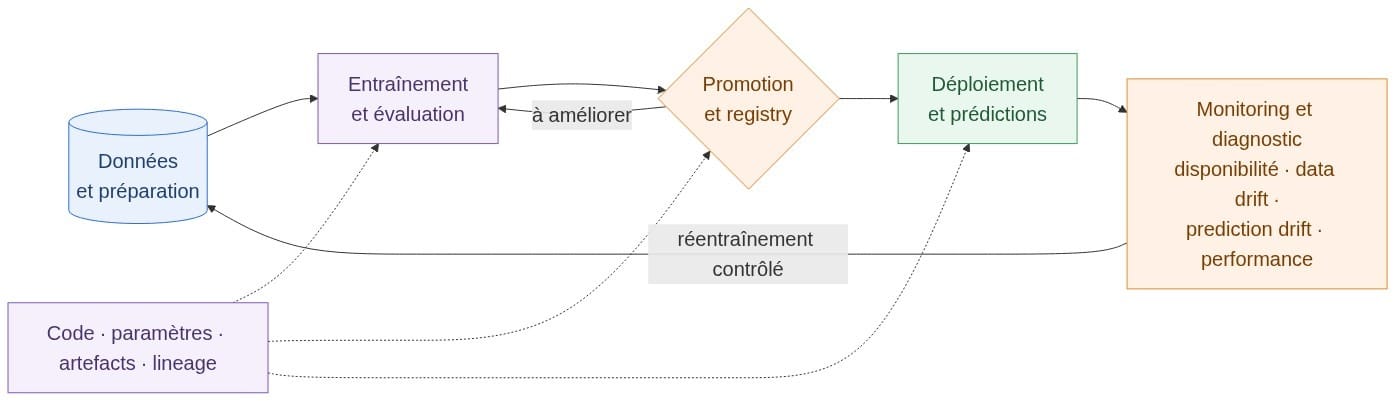
Figure 2 — La boucle MLOps relie la validation, la production, le monitoring et la décision de réentraîner.
Le gain ne vient pas de l’accumulation d’outils. Il vient de la capacité à répondre simplement à des questions opérationnelles : quel modèle est déployé ? Pourquoi l’a-t-on choisi ? Peut-on reproduire son entraînement ? Les prédictions restent-elles fiables ?
Pourquoi ZenML a retenu notre attention
Dans le cadre d’une mission d’industrialisation d’un cas d’usage de machine learning, nous avons cherché à structurer le cycle de vie d’un modèle sans multiplier les intégrations et conventions propres au projet. C’est dans ce contexte que ZenML a retenu notre attention.
ZenML est un framework MLOps open source qui permet de définir des pipelines ML en Python et de les connecter aux composants d'une stack ZenML. Il délègue l’exécution au composant orchestrateur configuré dans cette dernière. ZenML n’impose donc pas un orchestrateur unique ; il apporte une couche d’abstraction et de traçabilité entre les étapes du pipeline, les artefacts et les métadonnées qu’elles produisent.
ZenML conserve le lineage entre les données, les étapes d’entraînement, les évaluations et les modèles produits. Ce lien permet de remonter d’un modèle ou d’une prédiction vers les conditions de son entraînement.
ZenML ne remplace pas non plus une brique de monitoring. En revanche, il permet de rattacher les signaux exploités par une pipeline de réévaluation à une version précise du modèle et aux artefacts ayant conduit à son entraînement.
Versionner plus qu’un fichier modèle
Le véritable risque entre entraînement et production ne vient pas uniquement du poids du modèle. Il apparaît aussi lorsque les transformations appliquées à l’entraînement ne sont pas exactement celles utilisées au moment de la prédiction.
Un pipeline ZenML permet de rendre cette séparation explicite. Les résultats des @step deviennent des artefacts versionnés : jeu de données préparé, modèle entraîné, rapport d’évaluation ou, lorsque cela est pertinent, composant de prétraitement et manifest décrivant le schéma d’entrée attendu. Ces artefacts peuvent ensuite être associés à une version de modèle dans le Model Control Plane.
L’intérêt n’est pas de faire de ZenML un outil de serving. Le service de prédiction, son API et sa chaîne de déploiement restent des responsabilités distinctes. En revanche, ZenML permet de ne pas déployer un simple fichier récupéré dans un stockage : le pipeline de déploiement peut référencer une version promue, avec les artefacts et les métadonnées qui expliquent d’où elle provient.
ZenML peut aussi s’intégrer à des outils spécialisés. MLflow, par exemple, reste pertinent pour enregistrer et visualiser les paramètres, métriques, artefacts et exécutions d’expérimentation. Plutôt que de les opposer, il est plus juste de les associer : ZenML structure le workflow et son lineage ; MLflow enrichit le suivi et la comparaison des expérimentations.
Une stack ZenML réunit le graphe d’exécution défini avec @pipeline et @step, un composant orchestrateur, ainsi que les services qui gèrent les artefacts, les métriques et le cycle de vie des modèles.
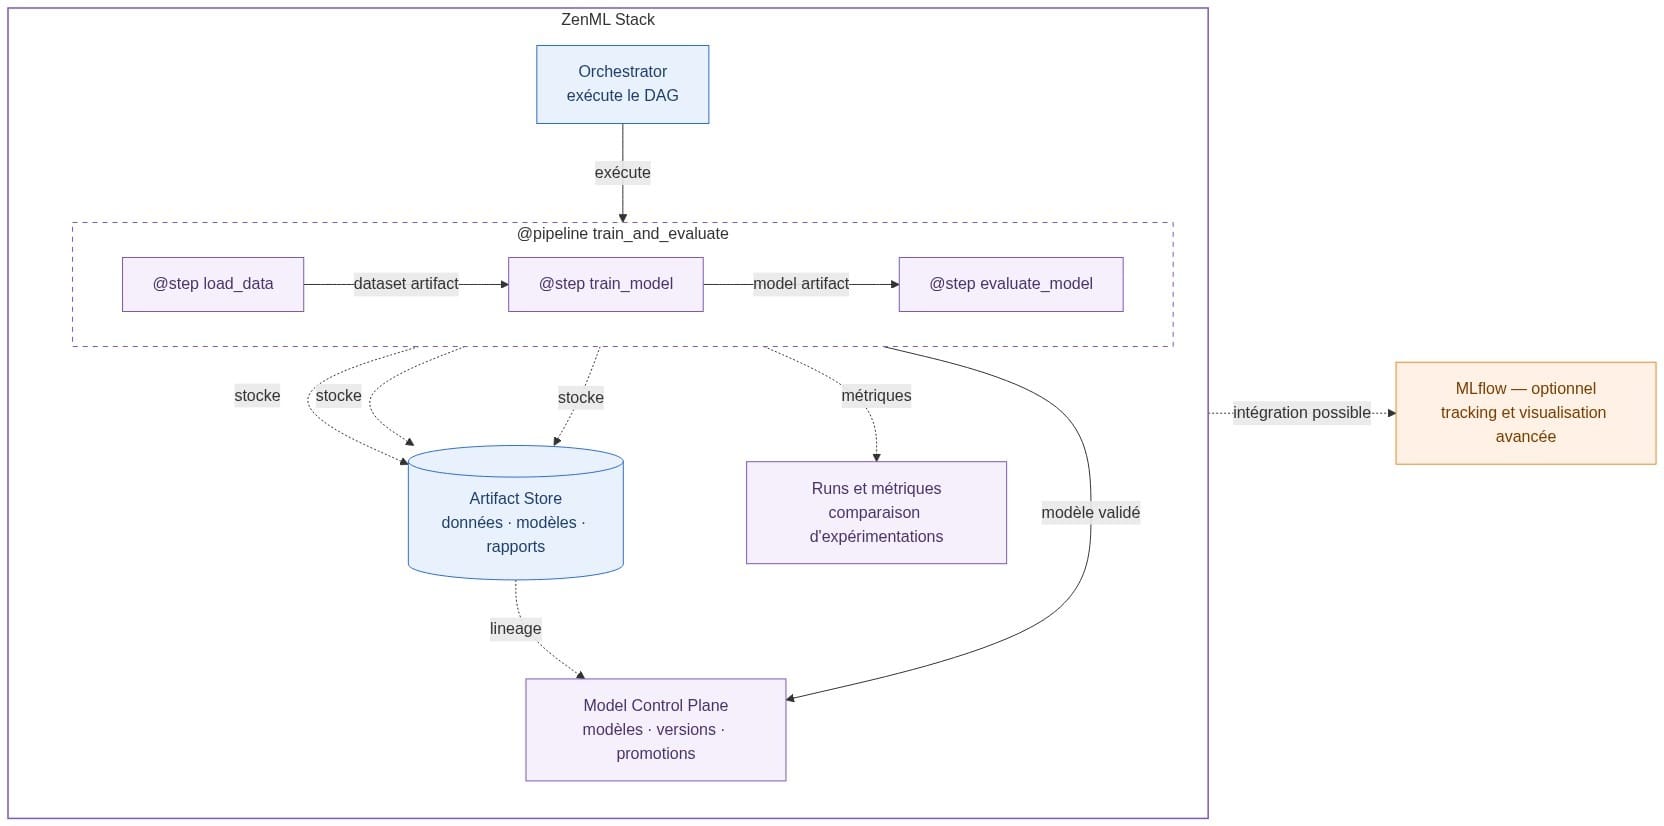
Figure 3 — ZenML relie l’exécution du pipeline à ses artefacts, ses métriques et ses modèles ; MLflow reste un complément optionnel.
Le bon débat n’est donc pas « ZenML ou MLflow ? ». Il est plutôt : de quelles garanties notre système ML a-t-il besoin, et quels outils permettent de les fournir sans réinventer une plateforme à chaque projet ?
Commencer petit, sans construire une usine à gaz
Toutes les équipes n’ont pas besoin d’une plateforme MLOps complète dès le premier jour.
Un orchestrateur seul peut être suffisant lorsqu’il s’agit d’un POC, d’un modèle unique, d’un faible volume de prédictions ou d’un cas d’usage à faible criticité. Dans ce contexte, l’objectif est de valider l’usage métier avant d’investir davantage.
Une progression pragmatique peut ressembler à ceci :
- Automatiser les entraînements et versionner le code.
- Ajouter un suivi systématique des données, paramètres, métriques et artefacts.
- Définir des règles explicites de validation et de promotion.
- Industrialiser le déploiement et le retour arrière.
- Mettre en place l’observabilité technique et métier.
- Centraliser ces pratiques lorsqu’elles deviennent communes à plusieurs équipes ou modèles.
L’important est de faire évoluer le niveau d’industrialisation en même temps que le niveau de risque et la valeur métier du modèle.
Conclusion
Un orchestrateur permet de faire tourner un pipeline. Une démarche MLOps permet de faire confiance au modèle qui en résulte, de le déployer de manière maîtrisée et de savoir quand il faut le corriger.
L’orchestration est donc une brique essentielle, mais elle n’est pas la plateforme. La véritable maturité MLOps apparaît lorsque données, code, artefacts, modèles, déploiements et signaux de production sont reliés dans une chaîne traçable.
ZenML peut jouer ce rôle de couche de cohérence, en s’appuyant sur l’orchestrateur et les outils déjà présents dans l’écosystème. L’objectif n’est pas d’ajouter un outil de plus : c’est de rendre explicites les garanties dont un produit ML a besoin pour durer en production.
Sources
- MLOps: Continuous delivery and automation pipelines in machine learning — Google Cloud
- Orchestrators — documentation ZenML
- Artifacts et lineage — documentation ZenML
- MLflow Tracking — documentation MLflow
- Intégration ZenML et MLflow — documentation ZenML
- Experiment trackers — documentation ZenML
- Models et Model Control Plane — documentation ZenML
- Kubeflow Pipelines Overview — documentation Kubeflow
