


Vos tests d'intégration démarrent une base PostgreSQL ou un serveur Redis avec Testcontainers. Sur les postes de développement, tout fonctionne. Mais une fois le pipeline exécuté par un GitLab Runner sur Kubernetes, le constat tombe : aucun environnement Docker n'est disponible.
La réponse habituelle consiste à ajouter Docker-in-Docker, souvent avec un conteneur privilégié. Une autre approche existe : conserver les appels à l'API Docker, mais confier la création des conteneurs à Kubernetes.
C'est le rôle de Kubedock. Comment fonctionne-t-il ? Comment l'associer à GitLab Runner ? Et surtout, dans quels cas constitue-t-il une alternative pertinente ?
Kubedock : une API Docker devant Kubernetes
Kubedock est une implémentation partielle de l'API Docker. Lorsqu'un client lui demande de démarrer un conteneur, il traduit cette demande en ressources Kubernetes, principalement des Pods et des Services.
Il ne lance donc pas un daemon Docker dans le conteneur du job. Les charges de travail sont exécutées par le runtime des nœuds du cluster, comme les autres Pods.
Cette approche vise avant tout des conteneurs éphémères, notamment ceux utilisés par les tests d'intégration. Elle n'a pas vocation à remplacer une plateforme de déploiement applicatif.
Un complément au runner, pas un nouvel executor
Une précision est essentielle : Kubedock n'est ni un GitLab Runner ni un executor GitLab natif.
Dans le montage présenté ici, chaque composant conserve son rôle :
- GitLab Runner récupère et pilote les jobs CI/CD.
- L'executor Kubernetes crée le Pod qui exécute chaque job.
- Kubedock reçoit les requêtes compatibles Docker émises par les tests et crée leurs dépendances dans le cluster.
On ne configure donc pas executor = "kubedock". L'executor reste kubernetes. Pour plus d'information sur les différents executors vous pouvez allez consulter cet article.
Pourquoi l'executor Kubernetes ne suffit-il pas ?
L'executor Kubernetes sait démarrer l'image du job ainsi que les services déclarés dans le pipeline. En revanche, il n'expose pas automatiquement d'API Docker au programme exécuté dans le job.
Or Testcontainers utilise cette API pour créer ses dépendances à la demande. Le fait que le test s'exécute déjà dans un conteneur ne lui donne pas la capacité d'en créer d'autres.
Plusieurs approches sont alors possibles :
Kubedock est particulièrement intéressant lorsqu'on souhaite conserver des tests pilotés par Testcontainers, tout en évitant le daemon Docker imbriqué du montage DinD classique.
En revanche, si votre pipeline n'a besoin que d'une instance PostgreSQL déclarée à l'avance, un service GitLab CI peut rester la solution la plus simple.
Comment fonctionne le montage en sidecar ?
Une intégration consiste à ajouter Kubedock comme sidecar, c'est-à-dire comme conteneur supplémentaire dans le Pod du job.
Ce Pod contient alors le conteneur de build, le helper GitLab Runner et Kubedock. Les dépendances demandées par Testcontainers sont créées dans d'autres Pods.
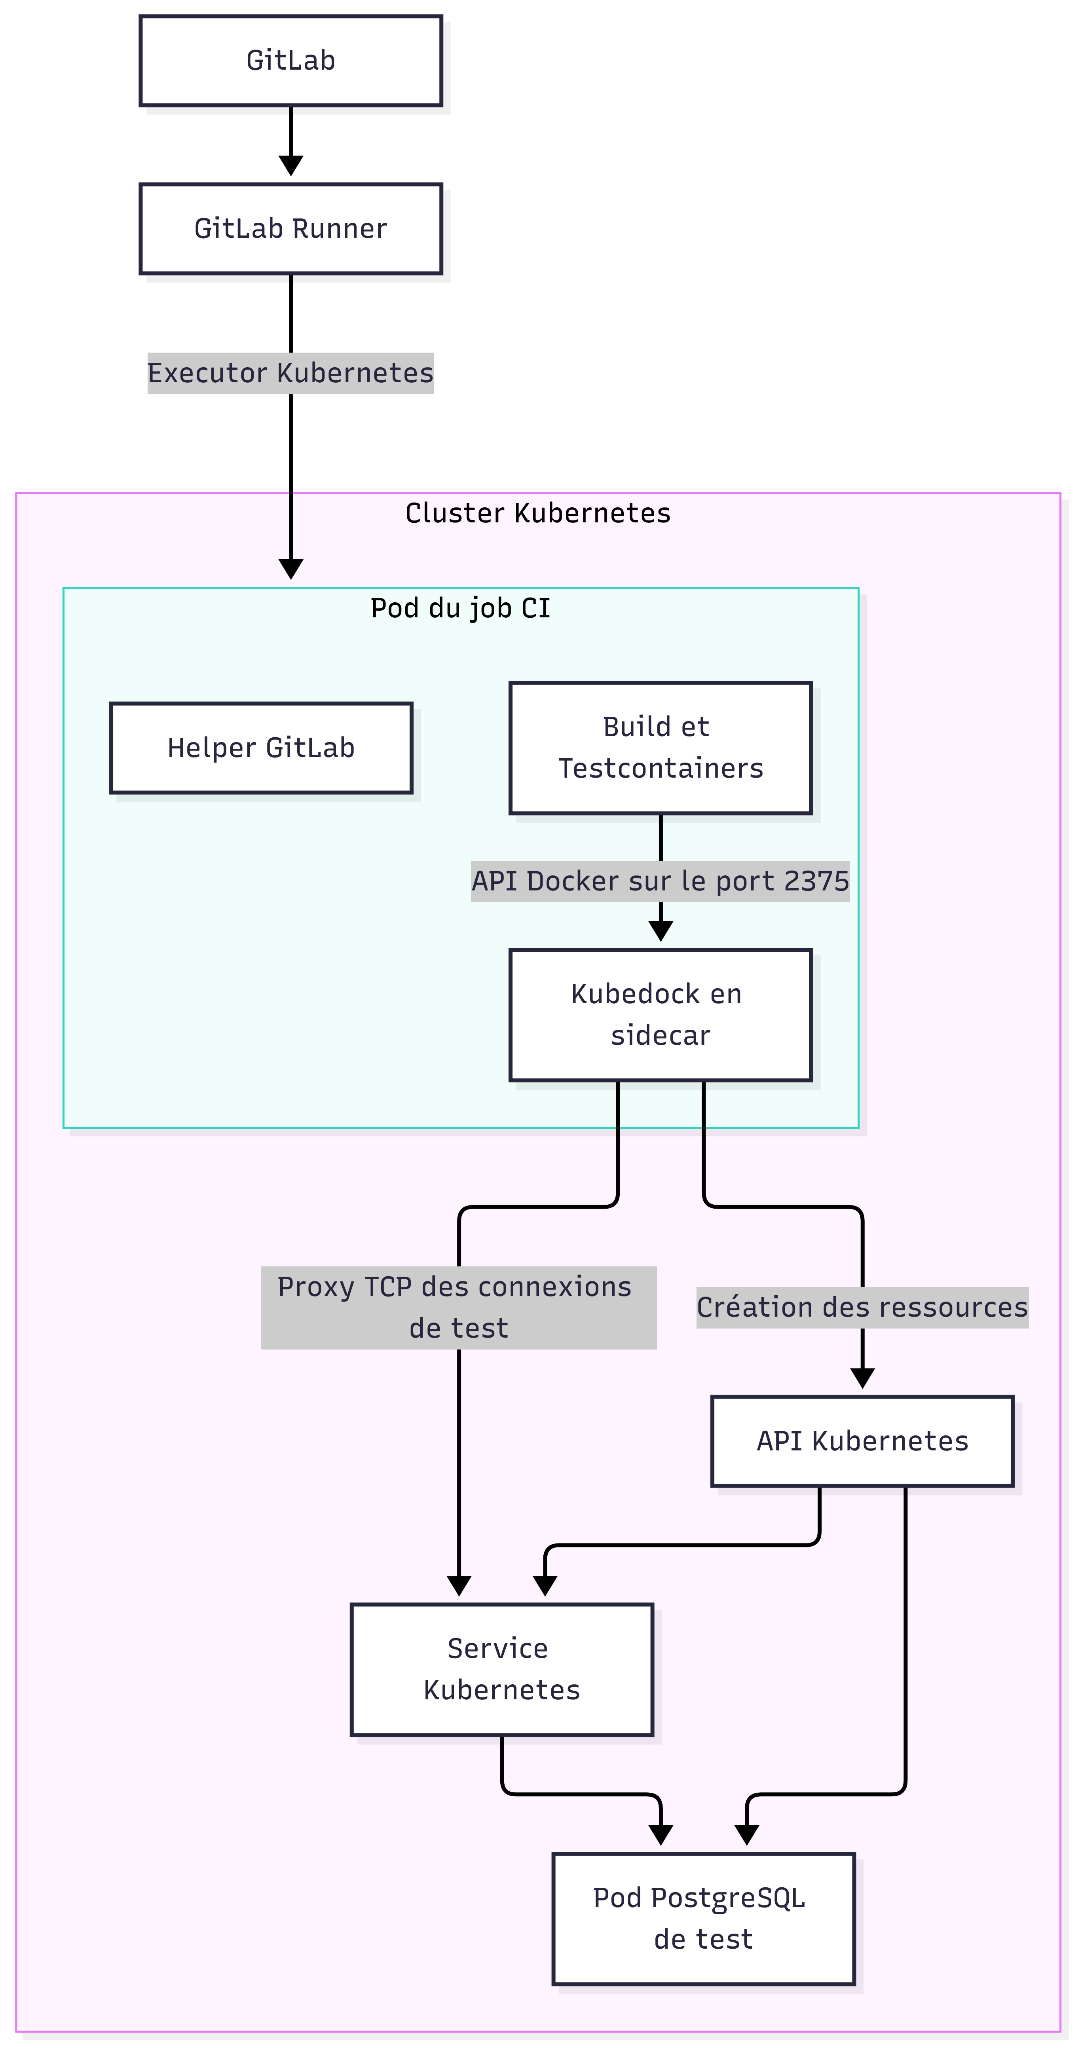
Le déroulement d'un test devient le suivant :
- GitLab Runner crée le Pod du job avec le sidecar Kubedock.
- Le code de test demande un conteneur PostgreSQL via l'API Docker de Kubedock.
- Kubedock crée les ressources Kubernetes correspondantes et attend le démarrage du Pod.
- Le test attend que PostgreSQL soit réellement disponible, puis s'y connecte.
- À la fin du test, la demande de suppression du conteneur entraîne la suppression des ressources associées.
Deux flux sont à distinguer : les appels à l'API compatible Docker, et les connexions applicatives vers PostgreSQL ou Redis. Le port 2375 sert au premier flux, pas aux requêtes SQL.
Avec --reverse-proxy, Kubedock rend également les ports applicatifs accessibles depuis le Pod du job. Les conteneurs d'un même Pod partageant leur réseau, le build peut joindre ce proxy sur 127.0.0.1.
Ce mécanisme est distinct de --port-forward, destiné notamment aux usages locaux. Ces deux options sont mutuellement exclusives.
Mettre en place un runner avec Kubedock
L'exemple suivant illustre un premier montage avec un runner déjà enregistré et déployé via le chart Helm GitLab Runner. Il se concentre sur l'ajout de Kubedock : l'URL GitLab, le jeton d'authentification du runner et sa configuration habituelle restent gérés séparément.
Les exemples utilisent Kubedock 0.23.0 comme version de référence, sans supposer qu'il s'agit de la dernière version. La combinaison GitLab Runner, Kubedock et Testcontainers doit être qualifiée avant généralisation.
Préparer le namespace et les permissions
Le namespace ci-tests accueille les jobs et leurs dépendances de test. Plusieurs jobs peuvent s'y exécuter simultanément, chacun avec son propre sidecar Kubedock. Il n'est pas nécessaire de limiter le runner à un seul job pour utiliser ce montage.
Le ServiceAccount kubedock-sa, créé dans ce namespace, doit disposer d'un Role et d'un RoleBinding lui accordant les permissions nécessaires :
Le projet Kubedock fournit un exemple de Role. Ces droits sont distincts de ceux du manager GitLab Runner, qui conserve ses propres permissions pour gérer les jobs.
Attention également à ne pas confondre l'identité de Kubedock avec celle des Pods qu'il crée. L'option Kubedock --service-account configure ces derniers, pas le sidecar lui-même. Les Pods de test ne doivent pas recevoir par défaut les permissions d'orchestration de Kubedock.
Ajouter le conteneur au Pod du job
Voici un extrait de valeurs Helm à intégrer à la configuration existante :
concurrent: 4
runners:
  config: |
    [[runners]]
      executor = "kubernetes"
      [runners.feature_flags]
        FF_USE_ADVANCED_POD_SPEC_CONFIGURATION = true
      [runners.kubernetes]
        namespace = "ci-tests"
        image = "maven:3.9.9-eclipse-temurin-21"
        privileged = false
        poll_timeout = 180
        service_account = "kubedock-sa"
        automount_service_account_token = false
        [[runners.kubernetes.pod_spec]]
          name = "kubedock-sidecar"
          patch_type = "strategic"
          patch = '''
            volumes:
              - name: kubedock-api-access
                projected:
                  sources:
                    - serviceAccountToken:
                        path: token
                        expirationSeconds: 3600
                    - configMap:
                        name: kube-root-ca.crt
                        items:
                          - key: ca.crt
                            path: ca.crt
                    - downwardAPI:
                        items:
                          - path: namespace
                            fieldRef:
                              fieldPath: metadata.namespace
            containers:
              - name: kubedock
                image: joyrex2001/kubedock:0.23.0
                command: ["/usr/local/bin/kubedock"]
                args:
                  - server
                  - --listen-addr
                  - 127.0.0.1:2375
                  - --namespace
                  - $(POD_NAMESPACE)
                  - --reverse-proxy
                  - --timeout
                  - 3m
                  - --reapmax
                  - 30m
                  - --request-cpu
                  - 100m,1000m
                  - --request-memory
                  - 256Mi,512Mi
                env:
                  - name: POD_NAMESPACE
                    valueFrom:
                      fieldRef:
                        fieldPath: metadata.namespace
                volumeMounts:
                  - name: kubedock-api-access
                    mountPath: /var/run/secrets/kubernetes.io/serviceaccount
                    readOnly: true
                resources:
                  requests:
                    cpu: 100m
                    memory: 128Mi
                  limits:
                    cpu: 500m
                    memory: 256Mi
                securityContext:
                  allowPrivilegeEscalation: false
                  capabilities:
                    drop: ["ALL"]
                  seccompProfile:
                    type: RuntimeDefault
          '''
La modification du PodSpec nécessite le feature flag FF_USE_ADVANCED_POD_SPEC_CONFIGURATION. Cette fonctionnalité est indiquée comme bêta dans la documentation GitLab consultée. La stratégie strategic permet d'ajouter le conteneur nommé kubedock sans remplacer toute la liste des conteneurs et perdre le build ou le helper.
Le montage automatique du jeton Kubernetes est désactivé. Un volume projeté apporte le jeton, le certificat de l'API et le namespace uniquement au sidecar. Le conteneur de build n'a pas besoin de recevoir directement ces identifiants.[b]
Dans cet exemple, l'API compatible Docker écoute uniquement sur la boucle locale du Pod, accessible au conteneur de build. Le reverse proxy utilise des écoutes distinctes pour les ports applicatifs des dépendances de test.
Enfin, deux budgets de ressources coexistent : resources dimensionne le sidecar, tandis que --request-cpu et --request-memory dimensionnent les conteneurs créés par Kubedock. La syntaxe 256Mi,512Mi indique une request de 256 Mi et une limit de 512 Mi. Ces valeurs illustratives doivent être adaptées aux dépendances testées.
Diriger Testcontainers vers Kubedock
Dans GitLab, attribuez le tag kubernetes-kubedock au runner. Pour un projet Maven qui dispose déjà de tests Testcontainers, le job peut ensuite ressembler à ceci :
stages:
  - test

integration-tests:
  stage: test
  image: maven:3.9.9-eclipse-temurin-21
  tags:
    - kubernetes-kubedock
  timeout: 20m
  variables:
    DOCKER_HOST: "tcp://127.0.0.1:2375"
    TESTCONTAINERS_HOST_OVERRIDE: "127.0.0.1"
    TESTCONTAINERS_RYUK_DISABLED: "true"
    TESTCONTAINERS_CHECKS_DISABLE: "true"
  script:
    - mvn --batch-mode verify
  artifacts:
    when: always
    reports:
      junit:
        - target/surefire-reports/TEST-*.xml
        - target/failsafe-reports/TEST-*.xml
Les variables remplissent des fonctions différentes :
- DOCKER_HOST désigne l'API compatible Docker de Kubedock.
- TESTCONTAINERS_HOST_OVERRIDE indique l'adresse utilisée pour joindre les ports applicatifs exposés, ici via le reverse proxy local.
- TESTCONTAINERS_RYUK_DISABLED désactive Ryuk, le mécanisme de nettoyage auxiliaire de Testcontainers.
- TESTCONTAINERS_CHECKS_DISABLE désactive les vérifications préalables de l'environnement Docker de Testcontainers Java.
Les deux dernières variables constituent un choix pour ce montage, pas une obligation universelle de Kubedock. Leur comportement doit être vérifié pour la version et l'implémentation de Testcontainers utilisées. Désactiver les vérifications ne rend pas une API manquante compatible, et désactiver Ryuk impose de prendre en charge le nettoyage autrement.
Aucun service docker:dind n'est nécessaire dans ce job. Le sidecar est ajouté par la configuration du runner.
Les bénéfices de cette approche
Éviter le daemon Docker privilégié
Kubedock ne nécessite pas de daemon Docker privilégié pour créer les dépendances de test. Il utilise l'API Kubernetes et s'appuie sur le runtime déjà présent sur les nœuds.
Rendre les dépendances visibles dans Kubernetes
Les bases de données et autres services de test deviennent des Pods ordinaires. Ils peuvent être observés avec les outils habituels : événements Kubernetes, logs, métriques CPU et mémoire, quotas et politiques d'admission.
Le scheduler peut les répartir entre plusieurs nœuds en fonction des ressources disponibles. Leur consommation n'est plus regroupée dans un daemon DinD associé au job.
Conserver le pilotage des dépendances dans les tests
Lorsque les fonctionnalités utilisées sont compatibles, le code Testcontainers conserve la responsabilité de démarrer et d'arrêter ses dépendances. Il n'est pas nécessaire de décrire chaque scénario dans le pipeline.
L'équipe plateforme prend en charge l'intégration Kubernetes ; les développeurs continuent à décrire les besoins de leurs tests dans leur langage habituel.
Les limites et points de vigilance
Kubedock ne remplace pas toutes les fonctions de Docker
Son API est partielle. Kubedock ne construit pas et n'importe pas d'images Docker : un pipeline reposant sur docker build ne peut pas simplement pointer vers Kubedock pour continuer à fonctionner.
La construction d'images doit être traitée séparément, par exemple avec une installation Buildah adaptée aux contraintes de la plateforme.
Les fonctionnalités avancées de Docker Compose, les appels d'API particuliers et les comportements d'attachement doivent également être testés. La compatibilité d'un scénario PostgreSQL ne prouve pas celle de toute une suite de tests.
Les volumes n'ont pas la même sémantique
Les montages de fichiers pris en charge reposent notamment sur des copies ou des ConfigMaps. Ils ne reproduisent pas un bind mount Docker classique avec synchronisation bidirectionnelle.
Un fichier produit dans le système de fichiers d'un Pod de test n'apparaît donc pas automatiquement dans le répertoire de travail du job. De même, le volume de travail partagé entre le build et le helper n'est pas automatiquement monté dans les Pods créés par Kubedock.
Vérifiez particulièrement les tests qui injectent des fichiers, récupèrent des résultats sur disque ou attendent un stockage partagé entre conteneurs. Ne supposez pas non plus qu'un volume nommé correspond à un PVC : les possibilités exactes dépendent de la version de Kubedock.
Le réseau en exécution parallèle
Les ports exposés pris en charge sont TCP. Les réseaux Docker ne sont pas reproduits comme des domaines isolés : Kubedock les ramène au namespace Kubernetes cible.
Cela n'empêche pas plusieurs instances de Kubedock de fonctionner en parallèle dans ce namespace. Chaque Pod de job possède son propre réseau : l'écoute de Kubedock sur 127.0.0.1:2375 ne crée donc pas de conflit de port entre les jobs.
Le risque de collision documenté concerne notamment les alias réseau identiques : un alias devient un Service Kubernetes portant ce nom. Deux jobs qui demandent simultanément le même alias dans le même namespace peuvent alors entrer en conflit. C'est un cas à vérifier, pas un échec systématique du parallélisme.
Lorsque les tests utilisent des alias explicites, rendez-les uniques entre exécutions simultanées si leur fonctionnement le permet. Préfixer uniquement les noms des Pods ne règle pas nécessairement les collisions sur les alias de Services.
Si les tests imposent des alias fixes, des namespaces séparés par job constituent une autre solution, sans être un prérequis général au parallélisme. Il faut alors y provisionner les comptes de service, les droits et les secrets de registre nécessaires ; l'option namespace_per_job du runner ne les installe pas à elle seule.
Kubedock propose aussi --lock pour les scénarios nécessitant un accès exclusif au namespace. Cette option requiert des droits sur les Leases Kubernetes et sérialise son utilisation par les instances participantes. Elle n'est pas activée dans l'exemple, qui conserve l'exécution simultanée des jobs.
Le nettoyage doit survivre aux échecs
Lors d'un fonctionnement normal, les demandes de suppression des tests et l'arrêt propre de Kubedock participent au nettoyage des ressources. Un arrêt brutal, une annulation ou la perte d'un nœud peuvent toutefois laisser des ressources orphelines.
Kubedock dispose d'un mécanisme de collecte périodique, réglable avec --reapmax. Il raisonne sur l'âge des ressources, pas sur leur absence d'activité. Une valeur trop courte peut donc interrompre un test encore en cours.
Dans l'exemple, la durée de 30 minutes dépasse le timeout de 20 minutes du job. Ce mécanisme n'est cependant actif que tant qu'une instance de Kubedock tourne. Prévoyez également un nettoyage externe des namespaces ou des ressources orphelines et testez explicitement les scénarios d'annulation.
Dans un namespace partagé, les seuils de collecte doivent tenir compte de la durée des tests de toutes les instances : le mécanisme peut aussi collecter des ressources anciennes créées par une autre instance. Cela ne signifie pas que chaque job supprime les ressources de ses voisins à sa terminaison ; le nettoyage à l'arrêt propre cible les ressources de l'instance, identifiées par le label kubedock.id.
En revanche, --prune-start supprime au démarrage les ressources portant le label kubedock=true, y compris celles d'autres instances. Cette option n'est pas activée dans l'exemple et ne doit pas être utilisée dans un namespace hébergeant des jobs simultanés dont les ressources doivent être conservées.
Quelques points d'exploitation
Accéder aux registres privés
Pour les registres privés, distinguez aussi les images du job et du sidecar des images demandées par les tests. Configurez les imagePullSecrets dans le namespace cible et transmettez leurs noms à Kubedock avec --image-pull-secrets lorsque nécessaire. Les images auxiliaires utilisées pour les copies de fichiers, notamment --initimage, doivent elles aussi être accessibles. Un docker login dans le build ne configure pas automatiquement les pulls des kubelets.
Mesurer les performances
Kubedock évite le daemon DinD, mais chaque dépendance entraîne des opérations sur l'API Kubernetes, du scheduling, éventuellement un téléchargement d'image et un démarrage applicatif. Le gain dépend donc des suites de tests et du cluster : comparez des exécutions représentatives, à froid comme à chaud, pour l'évaluer.
Comment choisir ?
Une adoption progressive est préférable : commencer par un runner dédié, migrer quelques suites compatibles, puis vérifier leur comportement en parallèle et le nettoyage après un échec avant d'élargir le périmètre.
Conclusion
Kubedock répond à un problème précis : permettre à des tests qui parlent l'API Docker de créer leurs dépendances dans Kubernetes, sans installer un daemon Docker dans chaque job.
Associé à l'executor Kubernetes de GitLab Runner, il offre une piste intéressante pour les tests d'intégration éphémères. Les bénéfices sont concrets : des dépendances visibles dans le cluster, un pilotage conservé côté Testcontainers et l'absence du montage DinD privilégié classique.
La décision repose surtout sur trois vérifications : la compatibilité des tests, leur comportement en parallèle et la fiabilité du nettoyage. Kubedock n'est pas un nouvel executor universel ; c'est un complément ciblé pour exécuter des dépendances de test directement dans Kubernetes.
