

Le 13 octobre 2026, Station F accueillait la quatrième édition d'ai-PULSE, la conférence annuelle de Scaleway, filiale cloud du groupe Iliad. Plus de 2 000 participants, une trentaine d'intervenants pour une journée technique qui mêle keynotes, démonstrations et annonces produit.
Au-delà du catalogue de nouveautés, la journée raconte une même histoire sous plusieurs angles : les modèles ouverts (open‑weight) ont rattrapé les modèles fermés, mais le terrain de jeu s'est déplacé. Il se joue désormais dans ce qui entoure le modèle (outillage, permissions, interfaces) et dans ce qui le fait tourner (le compute, et qui le contrôle). Voici ce que nous retenons, thème par thème.
La vision de Mozilla sur les modèles ouverts
Un tiers des charges de travail IA tournent sur des modèles ouverts, qui ne captent que 4 % des revenus mondiaux. Le chiffre, tiré du rapport State of Open Source AI publié par Mozilla en juillet, a servi de fil conducteur à Raffi Krikorian, CTO de Mozilla. Le même rapport mesure l'écart entre l'envie et la pratique : 79 % des développeurs utilisent des modèles ouverts, 51 % en ont mis un en production (contre 63 % pour les modèles fermés). Sa formule résume le problème : « open ships easy, open deploy hard ». Il manque encore l'outillage qui rend le run d'un modèle ouvert aussi simple qu'un appel d'API chez un fournisseur fermé.
Mistral Large 4 : un modèle de 1 000 milliards de paramètres
Pierre Stock, VP Science de Mistral, a présenté Mistral Large 4, surnommé « Le Chonk » : un modèle de 1 000 milliards de paramètres (49 milliards actifs, architecture mixture-of-experts), en preview publique depuis le 6 octobre, dont les poids seront publiés fin octobre après une phase d'audit de sécurité. Mistral le place dans le top 5 du Cyber Index d'Artificial Analysis et met en avant ses résultats en manufacturing. Détail de méthode intéressant : la dernière étape d'entraînement passe par du reinforcement learning dans une sandbox où le modèle agit réellement.
La couche harness, à ne pas sous-estimer
Le point le plus structurant de la keynote de Mozilla tient en une phrase : un nouveau layer est apparu entre le modèle et l'utilisateur, et c'est là que se joue le combat. Raffi Krikorian l'appelle le harness : l'ensemble qui entoure le modèle pour en faire un agent utile (boucle d'exécution, outils, mémoire, contexte, garde-fous). Son chiffre : un même modèle est 22 % meilleur avec un bon harness. Autrement dit, une part croissante de la valeur perçue d'un « modèle » vient en réalité de ce qui l'habille.
Il en dresse un état des lieux en trois niveaux. Les harness de code (Codex, les outils open source du même genre) sont matures. La couche interface utilisateur est en retard : nous interagissons encore avec les agents à travers des écrans pensés pour des humains. Enfin l'identité et les permissions sont le vrai trou : personne ne sait aujourd'hui gérer finement ce qu'un agent a le droit de faire, pour qui, et pendant combien de temps. Le rapport Mozilla donne un ordre de grandeur : 21 % seulement des entreprises déclarent disposer d'un cadre mature de gouvernance de leurs agents.
Pour les équipes qui construisent des agents, la conséquence est pratique : le choix du modèle pèse moins que l'investissement dans le harness, et c'est un choix qui reste ouvert. Les grands fournisseurs fermés livrent leur harness avec leur modèle ; l'écosystème ouvert doit construire le sien, et c'est précisément le chantier dans lequel Mozilla annonce vouloir investir.
Compute souverain : les annonces de Scaleway
Les annonces de Damien Lucas, CEO de Scaleway, dessinent une stratégie claire : ne plus dépendre d'un seul fournisseur de GPU ni d'un seul pays. Voici quelques annonces qui ont été faites pendant la keynote :
Trois lectures de ces annonces :
D'abord, Scaleway devient le premier cloud européen à proposer des GPU AMD MI355X à cette échelle. Au-delà du bras de fer AMD contre Nvidia, l'intérêt est la redondance : une entreprise qui porte ses workloads sur ROCm en plus de CUDA réduit son exposition à un fournisseur unique.
Ensuite, la chaîne complète de souveraineté matérielle n'existe pas encore : les supercalculateurs suédois et danois tourneront sur des puces américaines fabriquées pour l'essentiel à Taïwan. Les Jotunn8 de VSORA sont la seule brique européenne annoncée, limitée à l'inférence et attendue au premier semestre 2027. Il faut donc lire « souverain » comme « sous juridiction européenne » plutôt que « conçu en Europe ».
Enfin, le catalogue de modèles s’élargit en introduisant un des open-weight models les plus puissants du moment : GLM 5.3. Cette annonce montre que Scaleway peut suivre la tendance et proposer des modèles adaptés aux besoins des utilisateurs, tout en restant souverain.
PRESAGE : apprendre la physique du cloud pour prédire les pannes
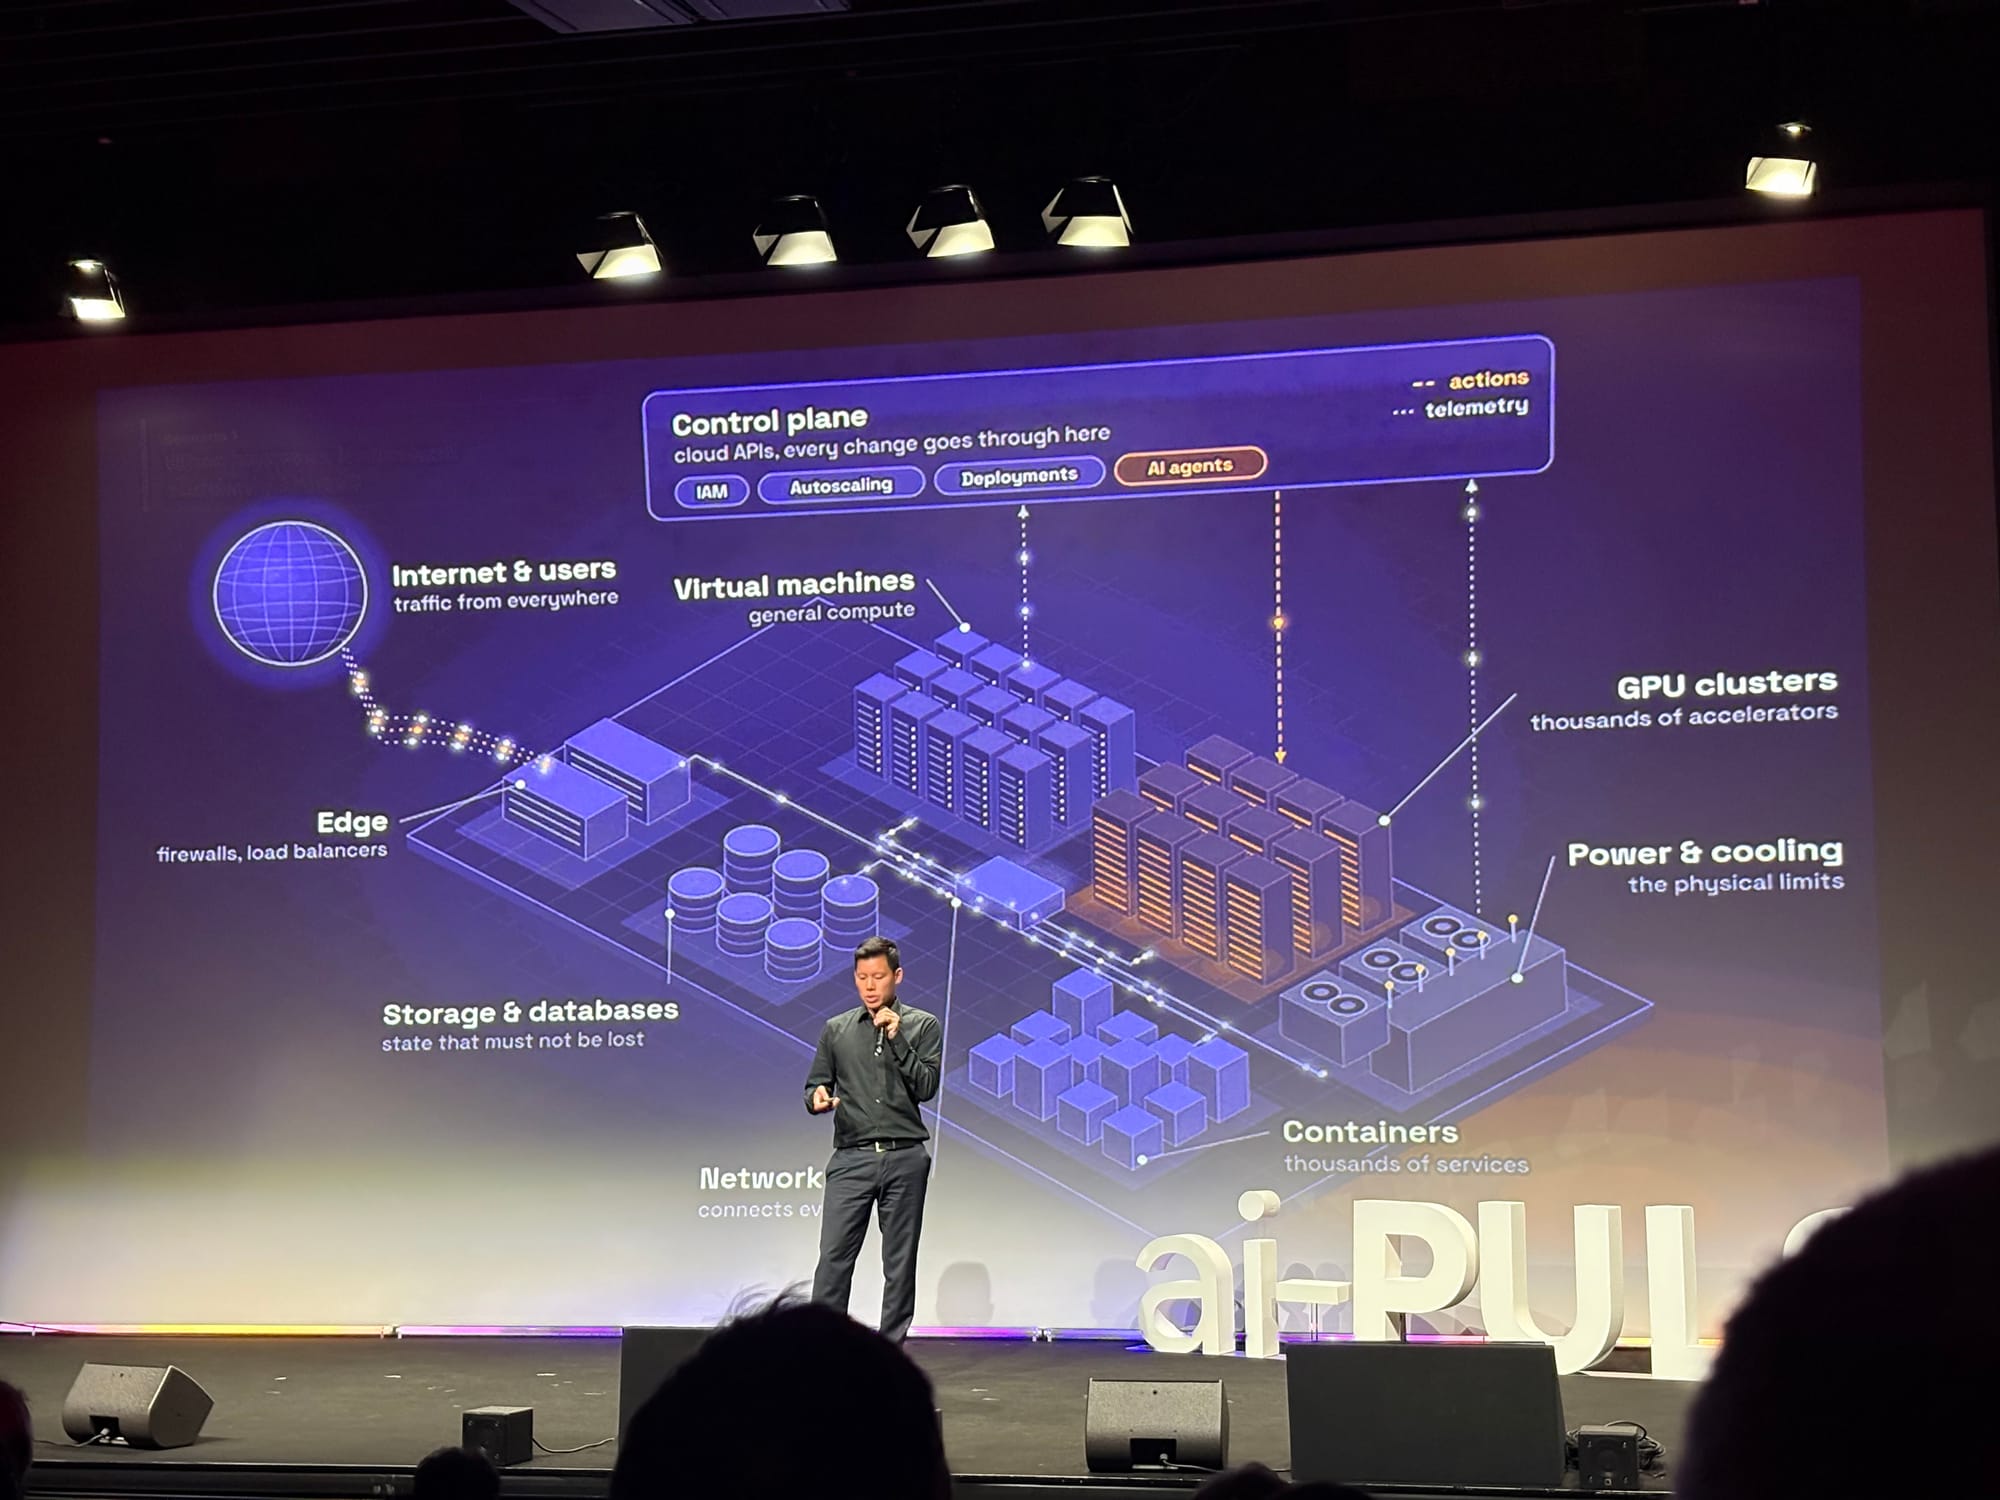
Tony Tung, cofondateur et CSO de PRESAGE, ancien de Meta, avec qui Scaleway a signé un partenariat, a présenté le concept de sa startup. Sa thèse part d'une analogie historique : en 1846, Neptune a été découverte par le calcul, à partir des perturbations observées sur l'orbite d'Uranus, avant d'être observée au télescope. La prédiction par la causalité a précédé l'observation. Le problème du cloud, dit-il, est que personne n'a écrit ses équations.
PRESAGE propose de les apprendre plutôt que de les écrire. Son « digital world model » ingère tout ce qu'une infrastructure produit (métriques, logs, événements du control plane, appels d'API), le tokenise, l'encode, puis entraîne un modèle à prédire la suite. Trois questions en découlent : quels événements vont se produire ? Est-ce que quelque chose va casser ? Qu'est-ce que telle action va changer ? Les modèles ont été entraînés sur une « data factory » constituée de vrais comptes cloud, avec des pannes réelles et chaque action enregistrée.
Les trois usages annoncés sont la prédiction des pannes en cascade avant qu'elles ne surviennent, la simulation d'un changement avant son déploiement, et l'optimisation du placement des workloads selon le compute, l'énergie et le refroidissement, donc l'empreinte environnementale.
Une idée mérite d'être poussée plus loin que la présentation ne l'a fait. Si un tel modèle devient fiable, l'environnement de préproduction perd une partie de sa raison d'être : on simule le changement sur le jumeau numérique, puis on déploie en production. L'économie actuelle est celle d'une infrastructure dupliquée, et c'est une ligne budgétaire que toutes les DSI connaissent. Nous restons dans l'attente d'un benchmark indépendant et de retours plus concrets sur des cas d'usage de ce world model, mais ce concept pourrait intéresser tous les SRE et FinOps.
La voix comme interface : de Siri aux agents speech-to-speech
Gradium a retracé quinze ans d'assistants vocaux pour expliquer leur vision de l’assistant vocal. L'anatomie de Siri est un pipeline en sept étapes : audio, transcription, compréhension (intention et entités), gestionnaire de dialogue, appel de services, génération de la réponse, synthèse vocale. Chaque étape est fermée. Si le scénario n'a pas été prévu à l'avance, la chaîne échoue, et l'utilisateur le sent immédiatement.
Mettre un LLM au milieu de ce pipeline règle une partie du problème (le scénario n'a plus besoin d'être écrit), mais empile les latences et perd l'intonation, les hésitations, les chevauchements de parole. La réponse de Kyutai, puis de Gradium, est le speech-to-speech : un modèle qui écoute et parle directement, sans passer par le texte. Moshi, publié en open source par Kyutai en 2024, en était la démonstration ; l'équipe a reconnu ses limites de l'époque, d'abord l'absence d'outils donnés à l’IA, qui en faisait un interlocuteur plutôt qu'un agent.
Le lien avec la keynote de Mozilla est direct. Raffi Krikorian pointait la couche interface comme la moins mature du harness ; Gradium propose que cette interface soit la voix en direct, avec un agent capable d'appeler des outils au milieu d'une conversation. Prise de rendez-vous, centres d'appels, interprétariat : les cas d'usage sont ceux où un écran est une gêne. Le chaînon manquant reste le même des deux côtés : l'appel d'outils et les permissions, qui restent plus difficiles à maîtriser en speech-to-speech qu'en texte.
Ce qu'on retient d'ai-PULSE 2026 : harness, souveraineté, world models
La capacité des modèles ouverts n'est plus le sujet. Les trois chantiers ouverts par cette édition sont ailleurs, et chacun a un propriétaire différent.
- Le harness est le vrai produit. Pour une équipe qui construit des agents, investir dans l'outillage, l'observabilité et la gestion des permissions rapporte plus que de changer de modèle tous les trois mois. C'est aussi là que l'écosystème ouvert est le plus en retard sur les fournisseurs fermés.
- La souveraineté se mesure par couche. Scaleway offre désormais une redondance matérielle (Nvidia, AMD, et VSORA en 2027) et juridictionnelle (régions à Paris, Milan, Copenhague, Stockholm). La chaîne restera partiellement américaine et taïwanaise pendant des années : il faut choisir le niveau de dépendance acceptable pour chaque workload plutôt que viser une pureté impossible.
- Les world models commencent à émerger, pour modéliser un jumeau numérique avec lequel l’IA pourrait jouer pour profiter d’une prédictibilité accrue. Appliqués à l'infrastructure cloud, ils posent des questions concrètes quant au mode de fonctionnement des infrastructures actuelles : que vaut un environnement de préproduction si l'on peut simuler le déploiement et ses conséquences à l’échelle ? Que deviendront l'observabilité et l'alerting dans un monde où tout doit être lu et compris par l’IA ? La réponse n'est pas pour demain, mais elle mérite d'être suivie.
En bref, c’était une journée qui a ouvert des perspectives et qui nous a fait réfléchir !
